データ統合
機能概要
機能の位置づけ
データ統合は、異種データソース間のデータ同期タスクを作成・設定・実行するための機能です。DataX 軽量タスクと Spark 分散タスクをサポートし、入力、変換、出力ノードを組み合わせて同期フローを構築します。
簡単に言えば、ソース表からデータを読み取り、必要に応じて変換し、ターゲット表またはデータソースへ書き込む同期ジョブを作成します。
主な特徴
- タスク管理:検索、追加、編集、詳細、削除、クローン、実行に対応します。
- DataX 軽量能力:単一ノードまたは軽量同期場面に適し、設定が簡単で導入しやすい方式です。
- Spark 分散能力:大規模データ、分散処理、複雑変換、クラスター資源を利用する同期場面に適します。
- 同期フロー設定:表入力、変換、表出力などのノードを構成できます。
- スケジューリング管理:定期実行、タスク状態、スケジュール状態、手動実行に対応します。
- インスタンス追跡:実行インスタンスとログを確認し、同期結果を追跡できます。
DataX 軽量能力
DataX は軽量なデータ同期場面に適し、単純な表間同期、少量から中量のデータ転送、環境依存を抑えたいタスクで利用しやすい方式です。設定が直接的で、一般的な関係型データベース間の同期に向いています。
Spark 分散能力
Spark は分散計算能力を利用し、大規模データの読み書き、複雑な変換、広い表、長時間バッチ、クラスター資源が必要な同期処理に適します。複数 Executor による並列処理により、データ量が大きい場合でも処理能力を拡張できます。
適用範囲
データベース間同期、データ入湖、データウェアハウス取込、ODS から DWD への加工、定期バッチ同期、プロジェクト内のデータ流通処理に適用します。
事前準備
前提条件
- qData プラットフォームにログインしていること。
- 対象プロジェクトに切り替えていること。
- 入力と出力に利用するデータ接続が作成済みであること。
- ソース表、ターゲット表、項目マッピング、同期条件が明確であること。
- Spark タスクを利用する場合は、関連クラスター資源と実行環境が利用可能であること。
ナビゲーションパス
データ開発 > データ統合
ページ全体
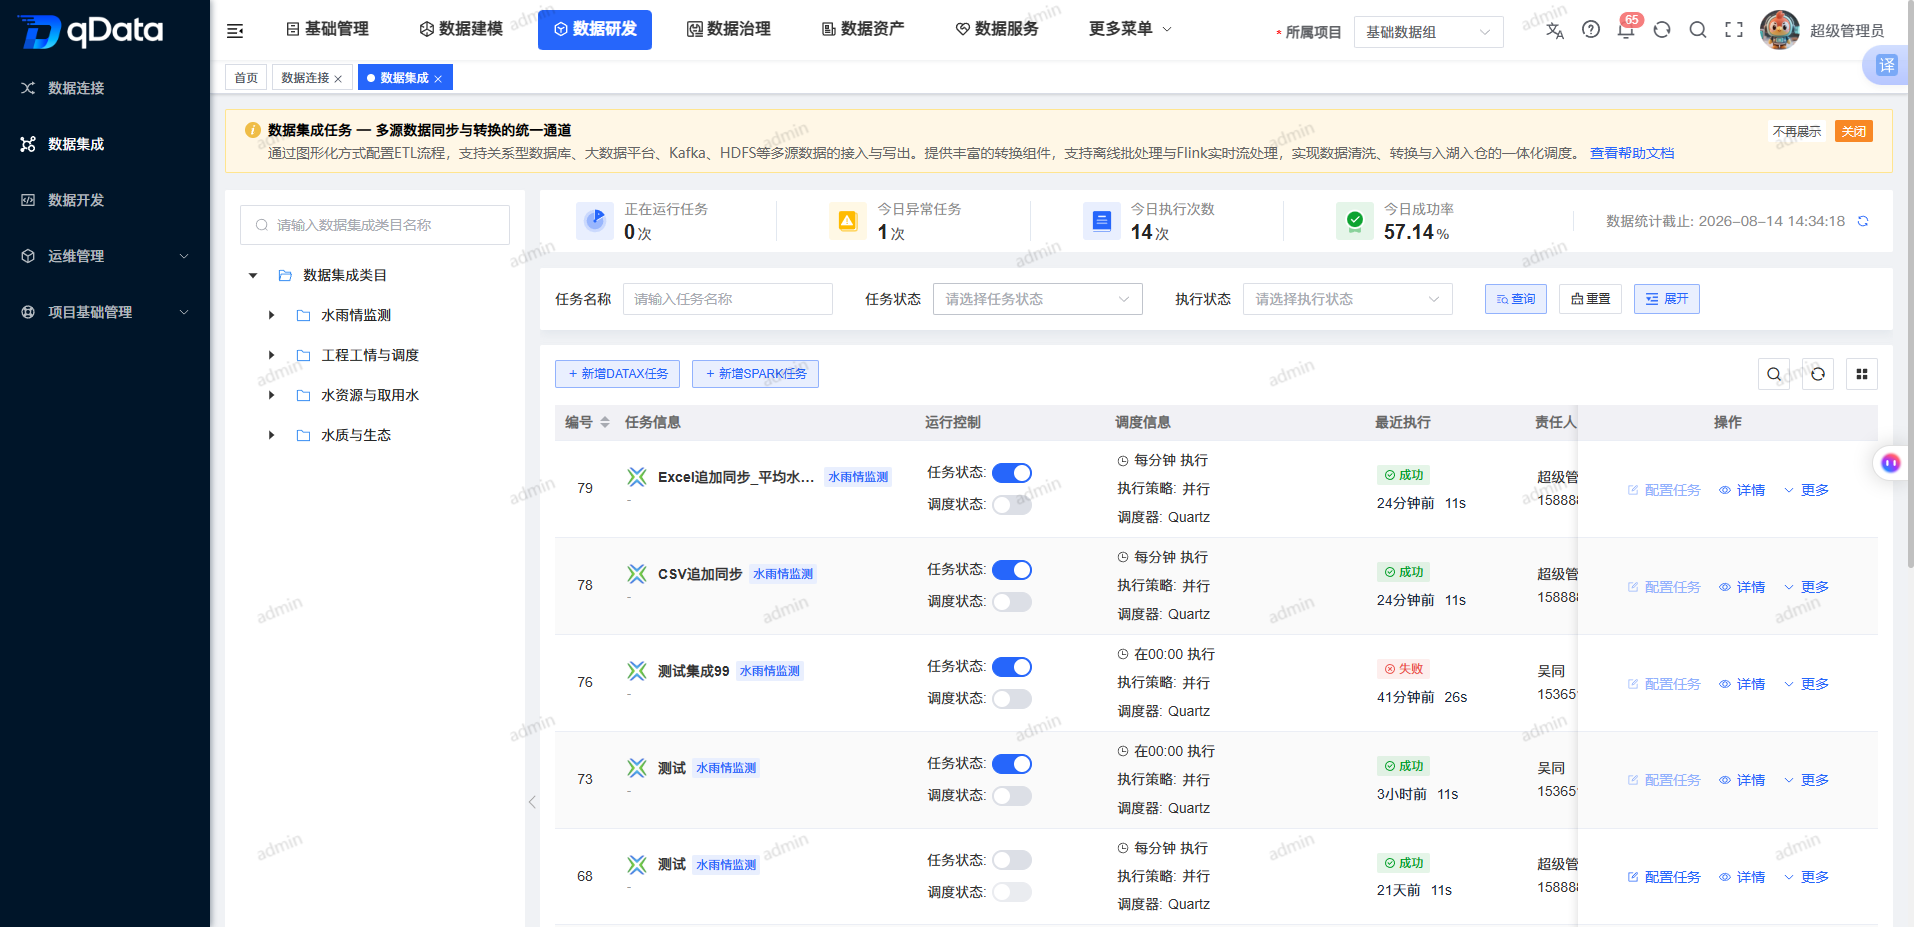
データ統合ページでは、タスク一覧、検索条件、追加入口、行操作を確認できます。一覧にはタスク名、実行器タイプ、状態、作成情報、最近実行情報などが表示されます。
推奨操作フロー
DataX タスク:【追加】-> DataX を選択 -> 基本情報と実行資源を設定 -> 同期フローを設定 -> スケジューリングを設定 -> 公開して実行します。
Spark タスク:【追加】-> Spark を選択 -> 分散実行資源を設定 -> 入力、変換、出力ノードを設定 -> スケジューリングを設定 -> 実行インスタンスを確認します。
運用確認:対象タスクを検索 -> 【実行インスタンス】を確認 -> 必要に応じてログを確認します。
機能操作説明
タスクを検索・特定する
タスク名、状態、カテゴリ、作成者などの条件で対象データ統合タスクを検索し、一覧でタスク基本情報と操作入口を確認します。
DataX データ統合タスクを追加する
【追加】をクリックし、DataX タスク作成画面で基本情報、実行パラメータ、資源設定を入力します。
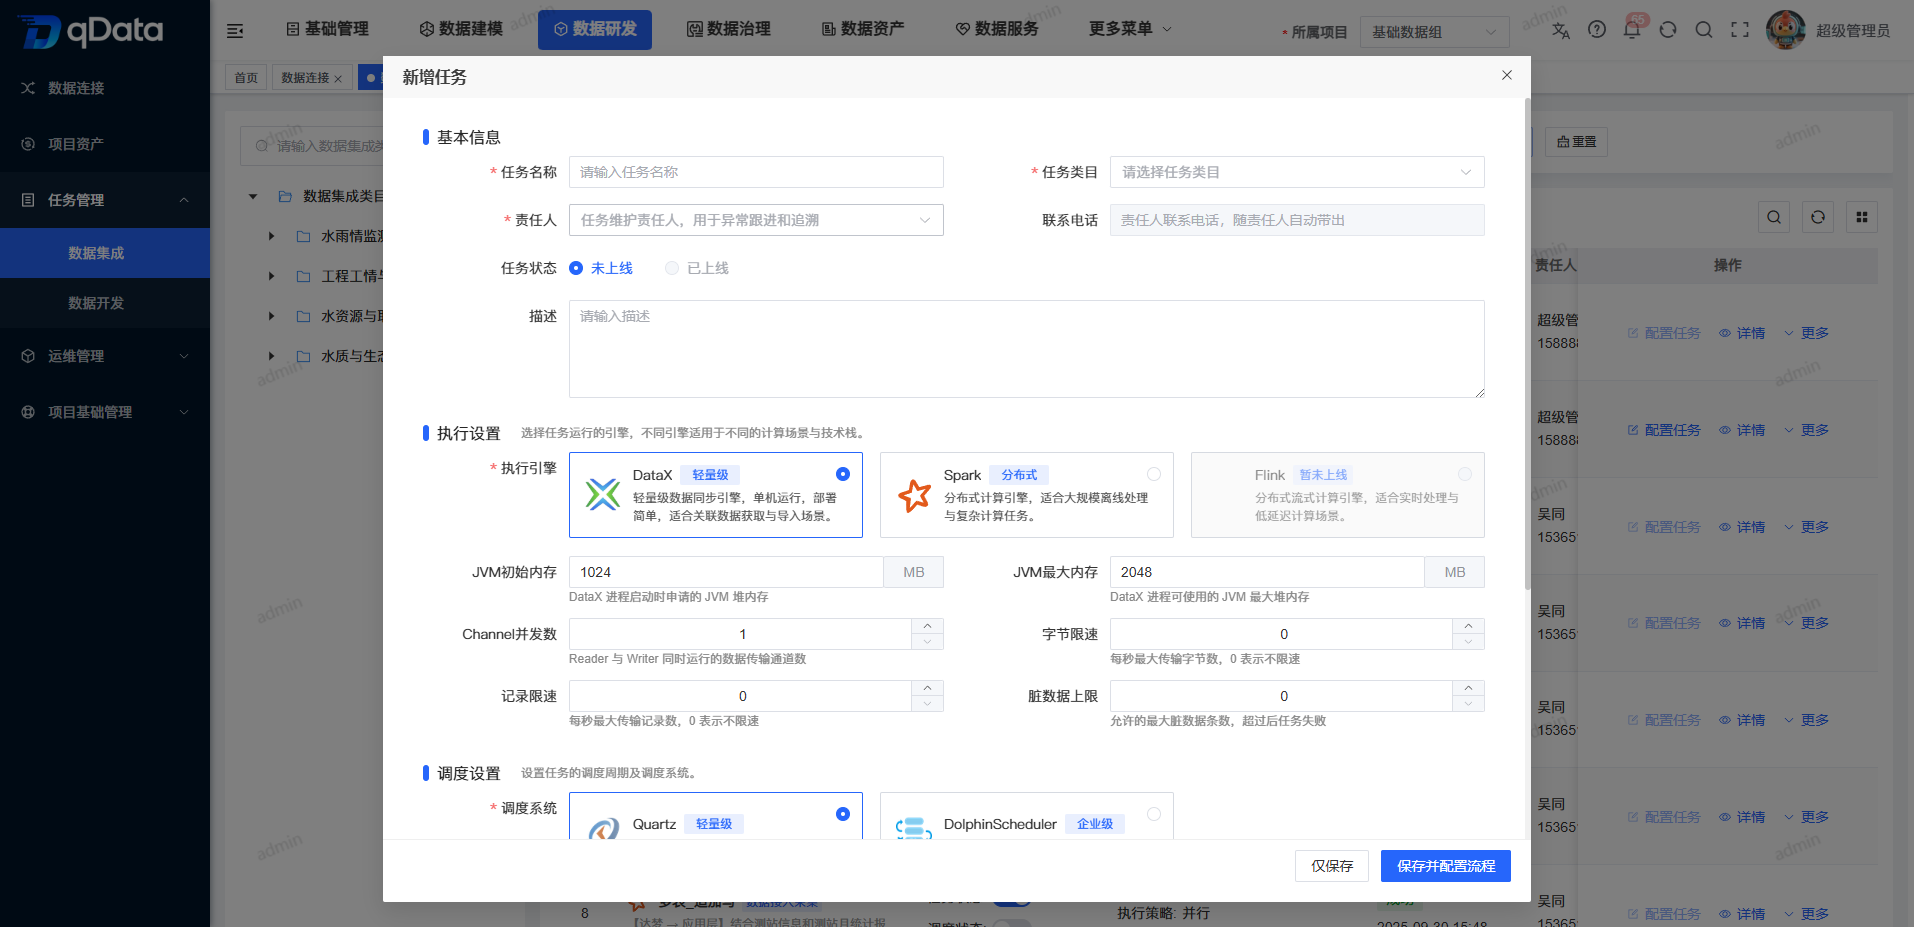
基本情報
| 項目 | 説明 | 入力のすすめ |
|---|---|---|
| タスク名 | データ統合タスクの表示名です。 | ソース、ターゲット、用途を含めると識別しやすくなります。 |
| タスクカテゴリ | タスク所属カテゴリです。 | プロジェクトのカテゴリ規則に従います。 |
| 実行器タイプ | DataX または Spark などを選択します。 | 軽量同期では DataX を選択します。 |
| 説明 | タスク用途と同期範囲を説明します。 | 業務背景と注意点を記載します。 |
実行パラメータと実行資源
| 項目 | 説明 | 入力のすすめ |
|---|---|---|
| 同期方式 | 全量、増分などの同期方式です。 | データ更新方式に合わせます。 |
| 並列数 | 同期処理の並列度です。 | データ量とソース負荷を考慮します。 |
| 失敗再試行 | 失敗時の再試行回数または策略です。 | ネットワークや一時失敗が多い場面で設定します。 |
| 実行資源 | タスクが利用する実行環境です。 | 環境能力と負荷を確認します。 |
DataX 適用場面
- 関係型データベース間の定期同期。
- 少量から中量の表データ同期。
- 複雑な分散計算が不要な同期。
- 軽量で設定しやすいタスクが必要な場面。
Spark 適用場面
- 大規模データ同期や広い表処理。
- 複雑な変換、フィルタ、計算ロジックが必要な場面。
- クラスター資源を利用して並列処理したい場面。
- 長時間バッチやデータウェアハウス加工処理。
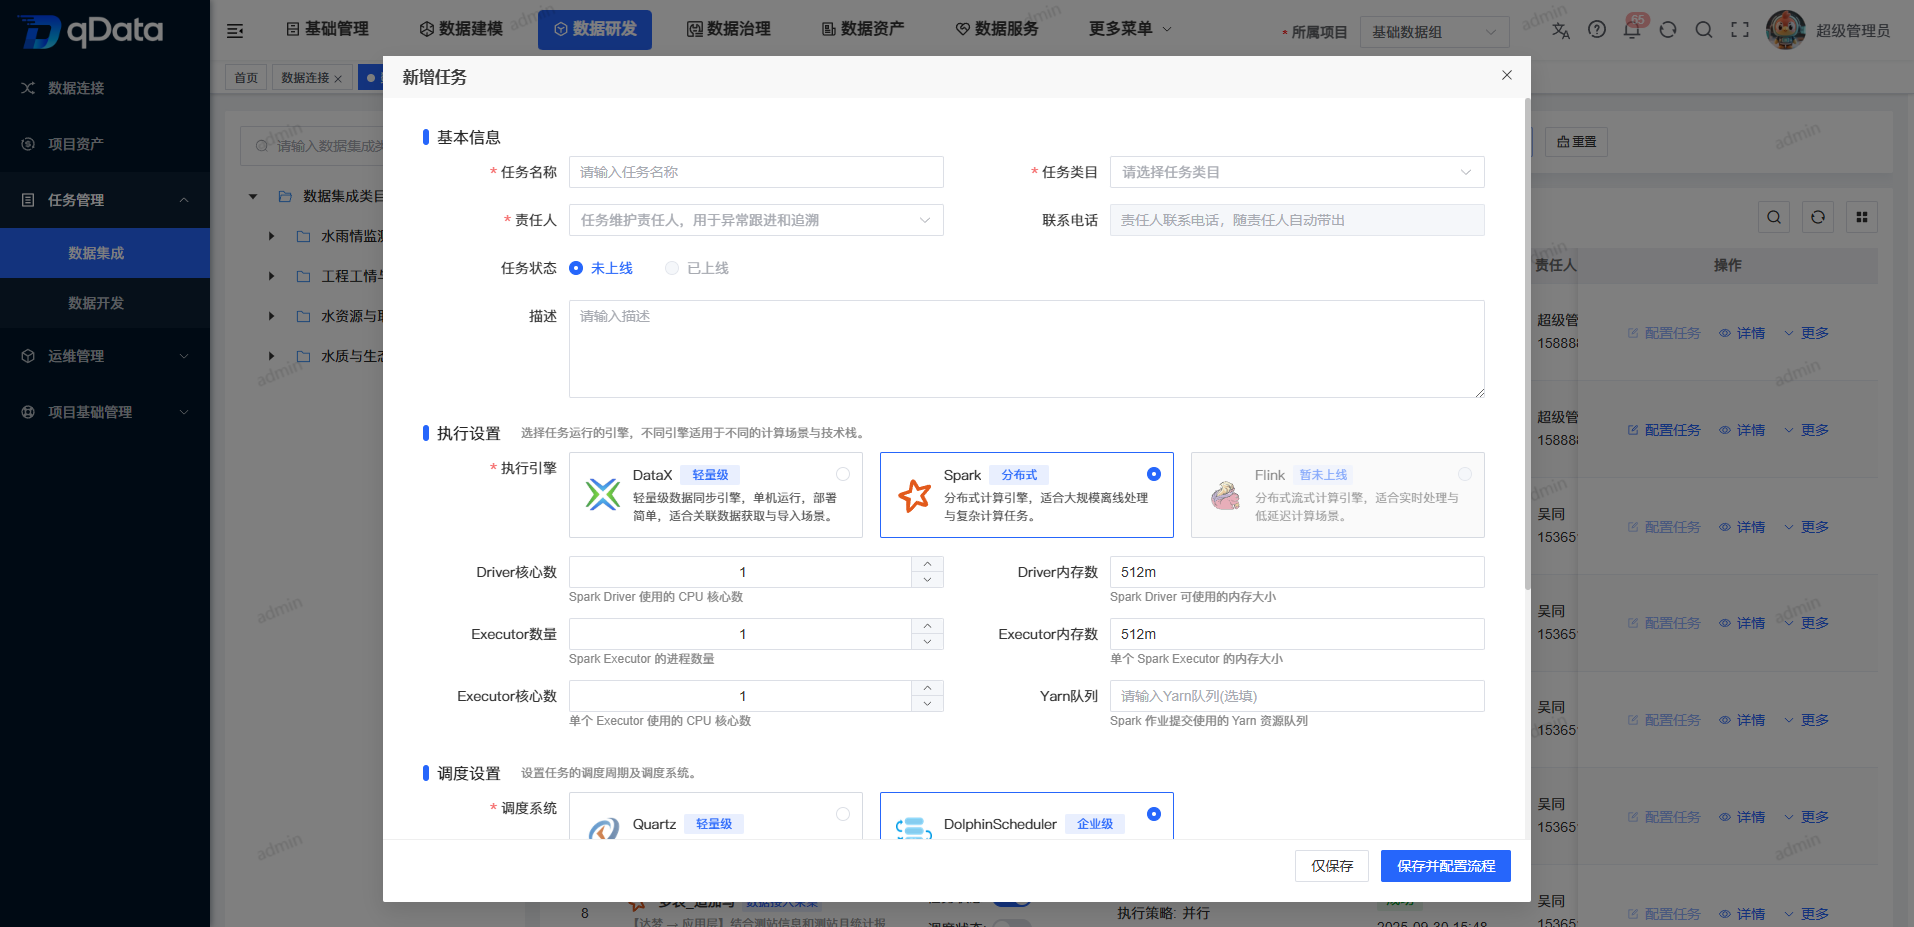
Spark データ統合タスクを追加する
Spark タスク作成画面で、分散実行に必要な資源、並列度、実行パラメータを設定します。
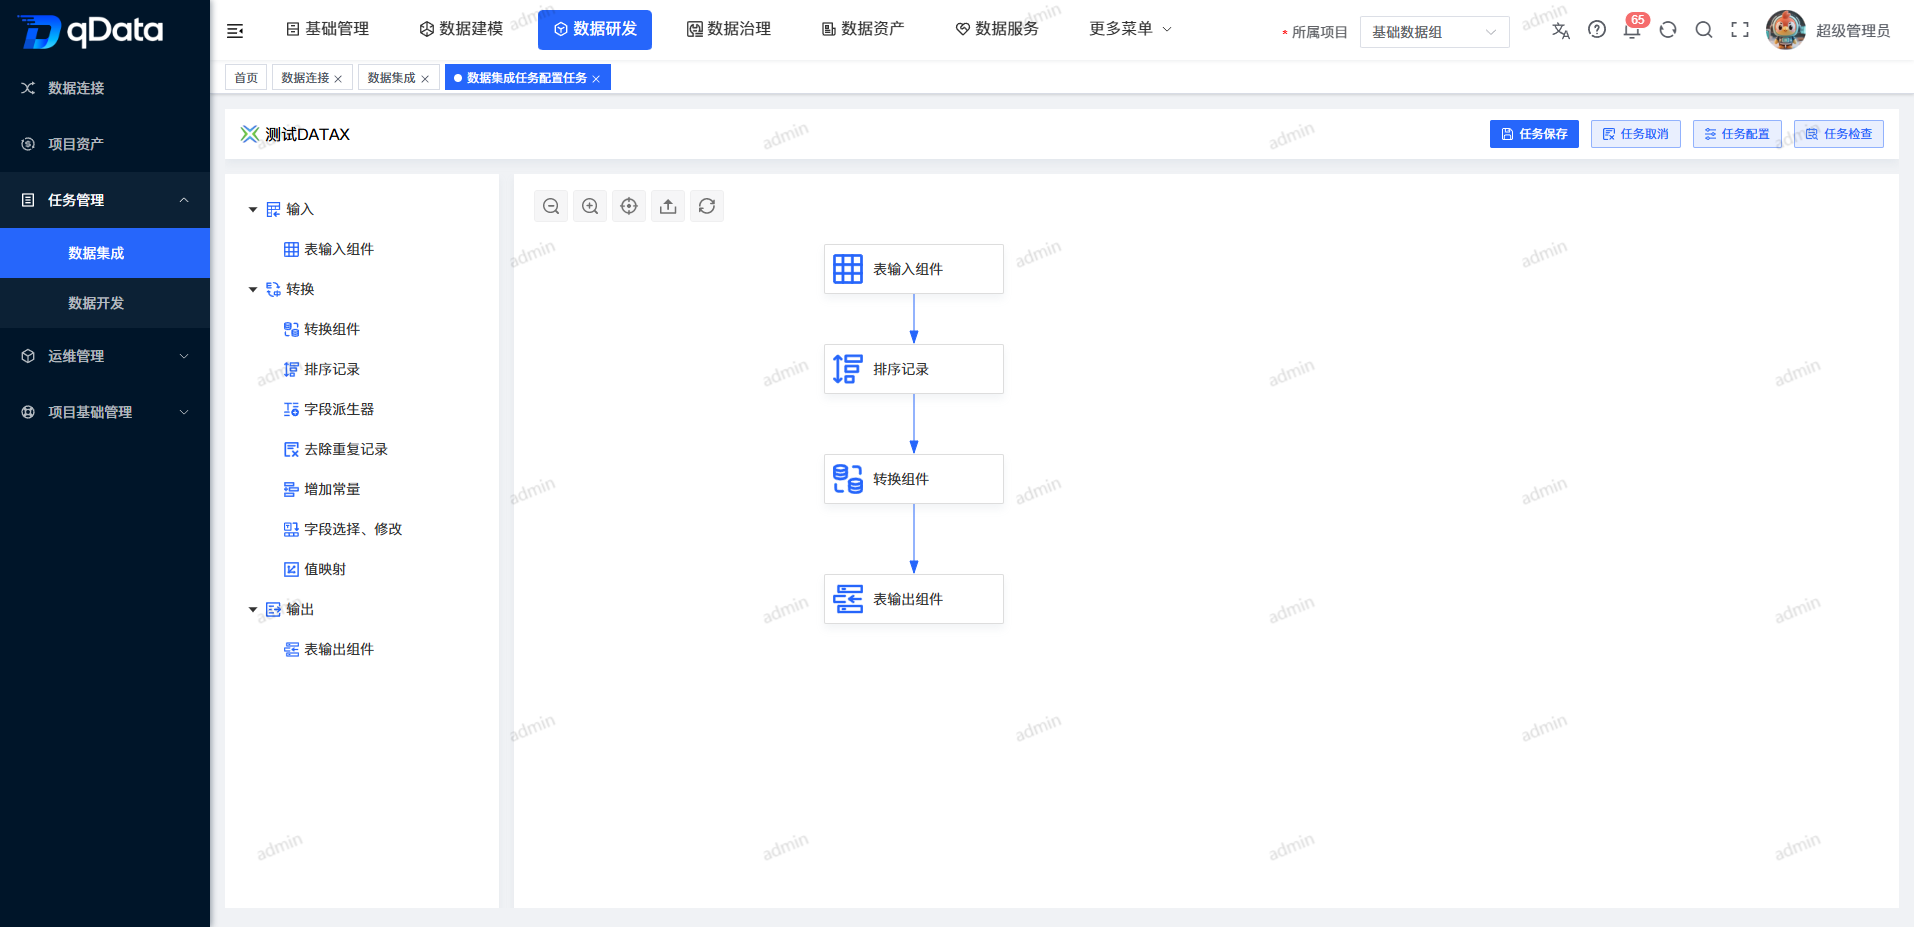
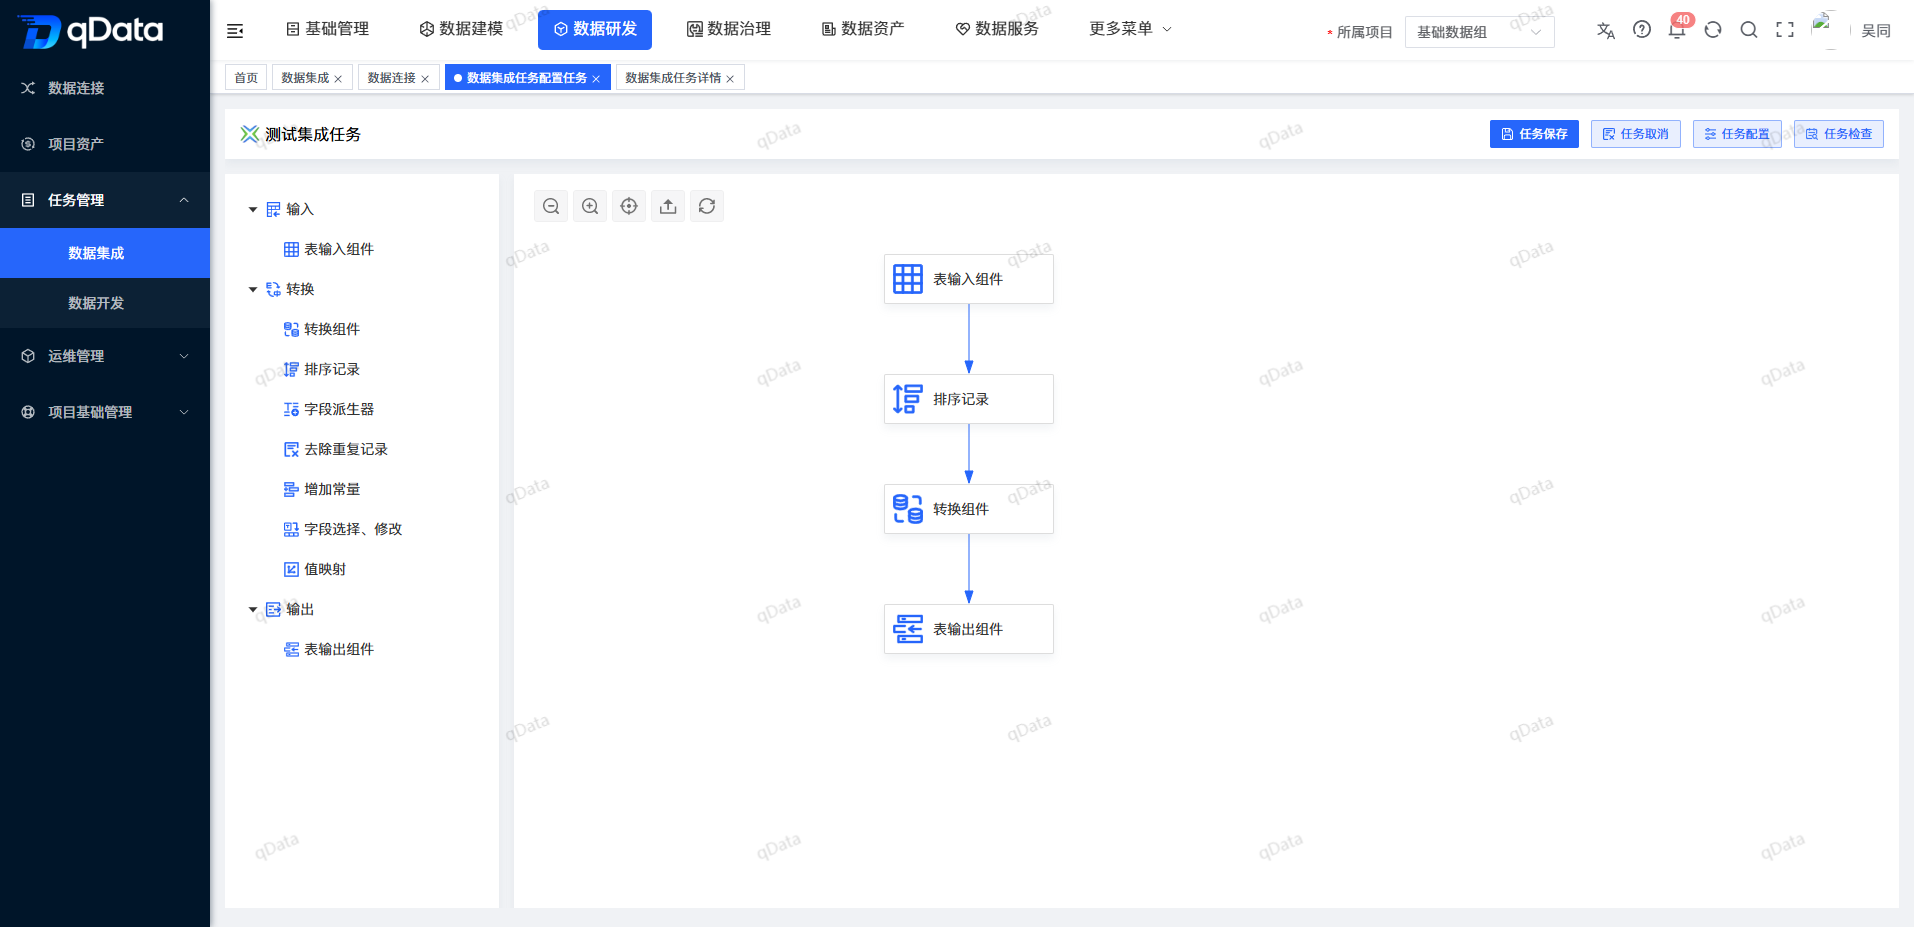
同期フローを設定する
タスク設定画面で入力、変換、出力ノードを配置し、項目マッピングと処理規則を設定します。
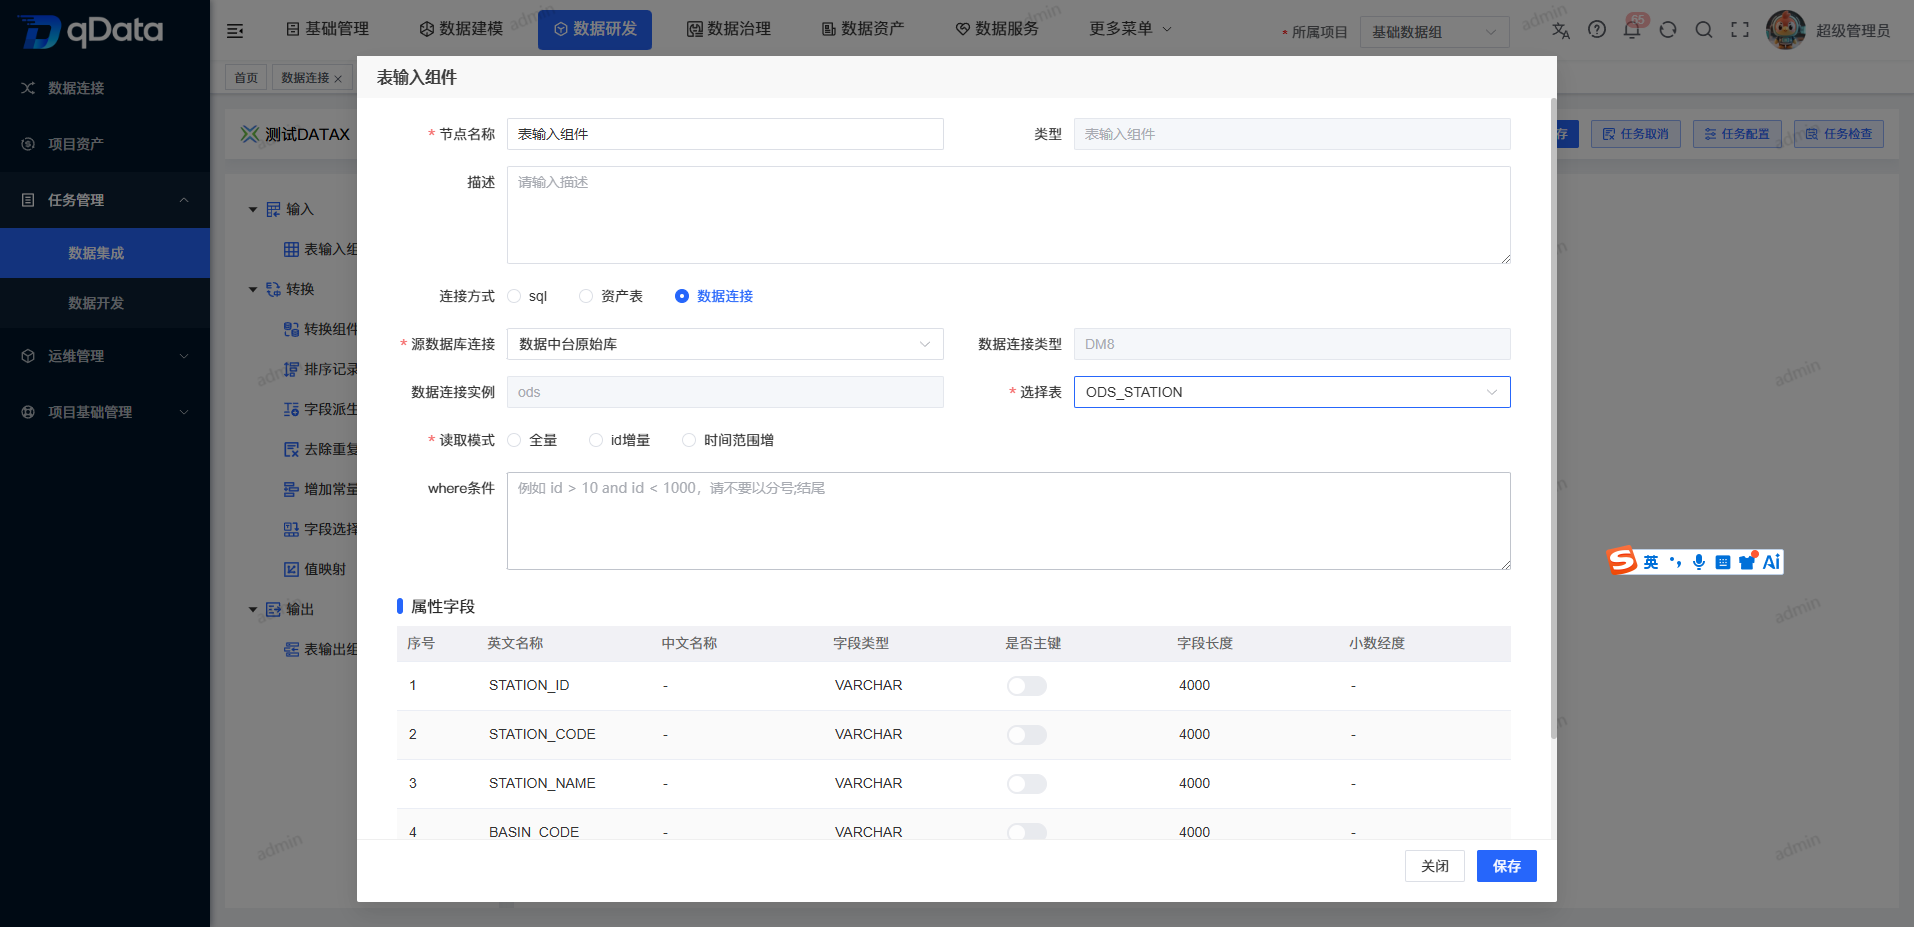
表入力コンポーネント
表入力コンポーネントでは、ソース接続、データベース、表、項目、抽出条件を設定します。
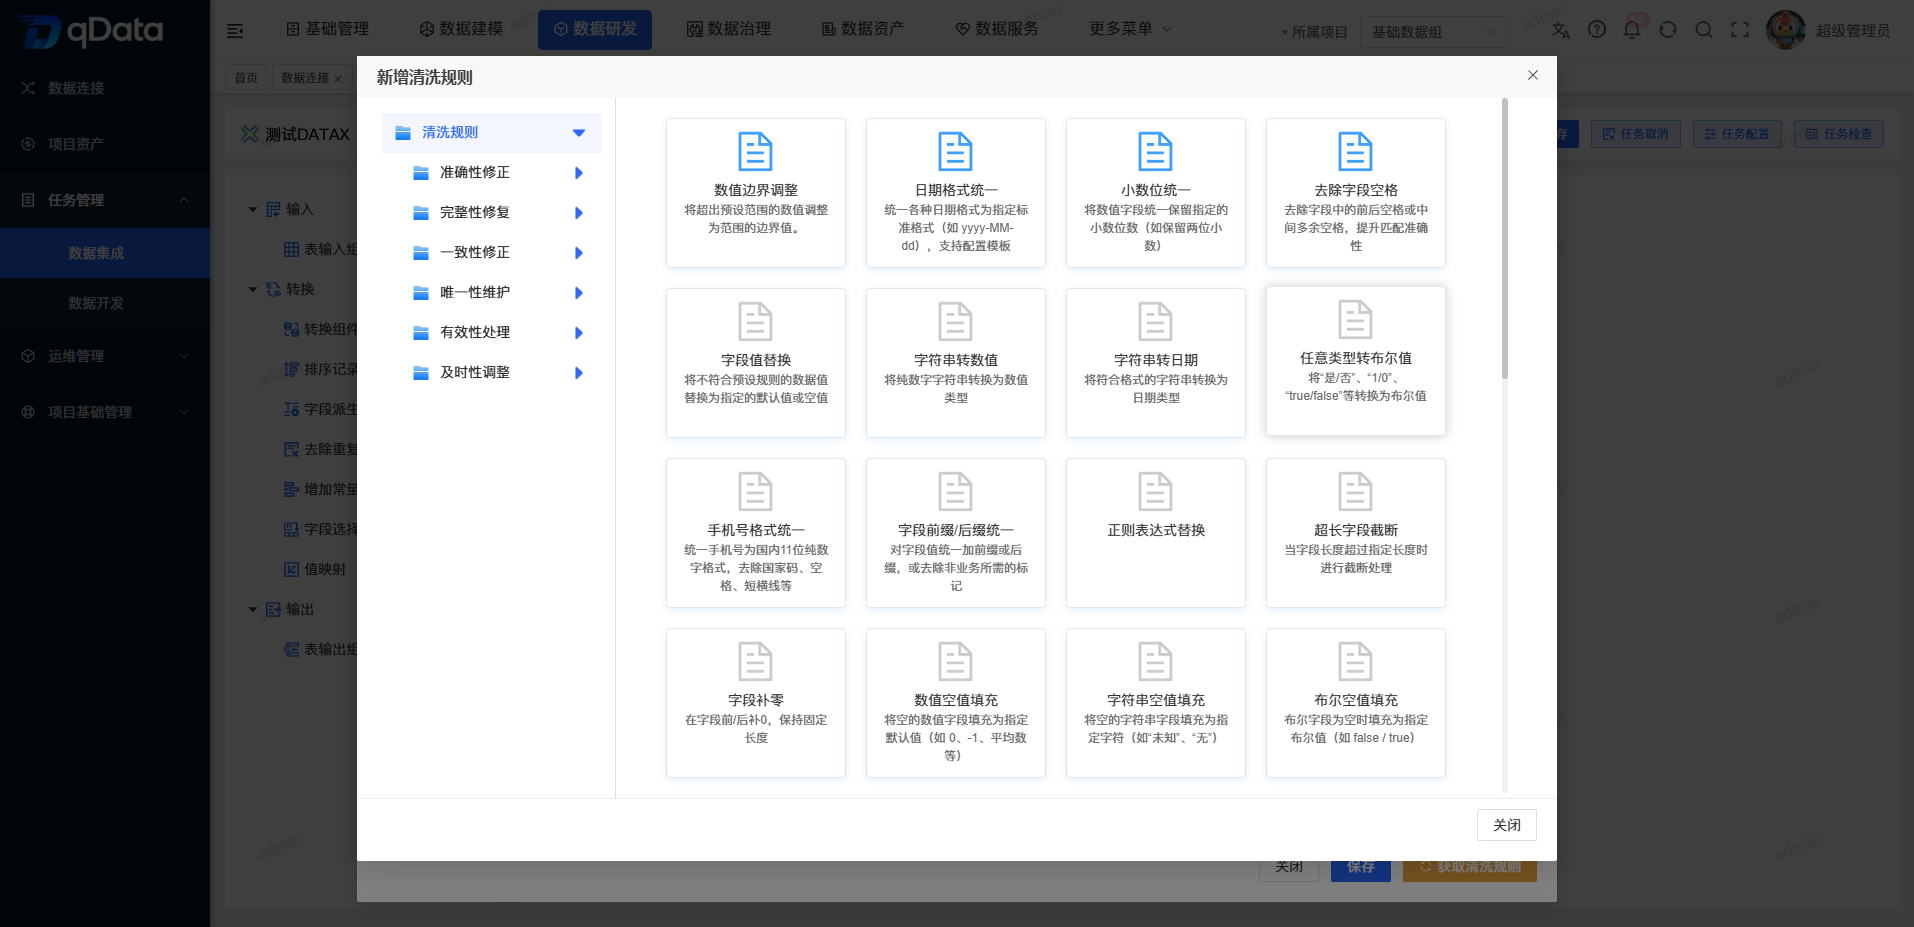
変換コンポーネント
変換コンポーネントでは、項目変換、フィルタ、式、マッピング規則を設定できます。
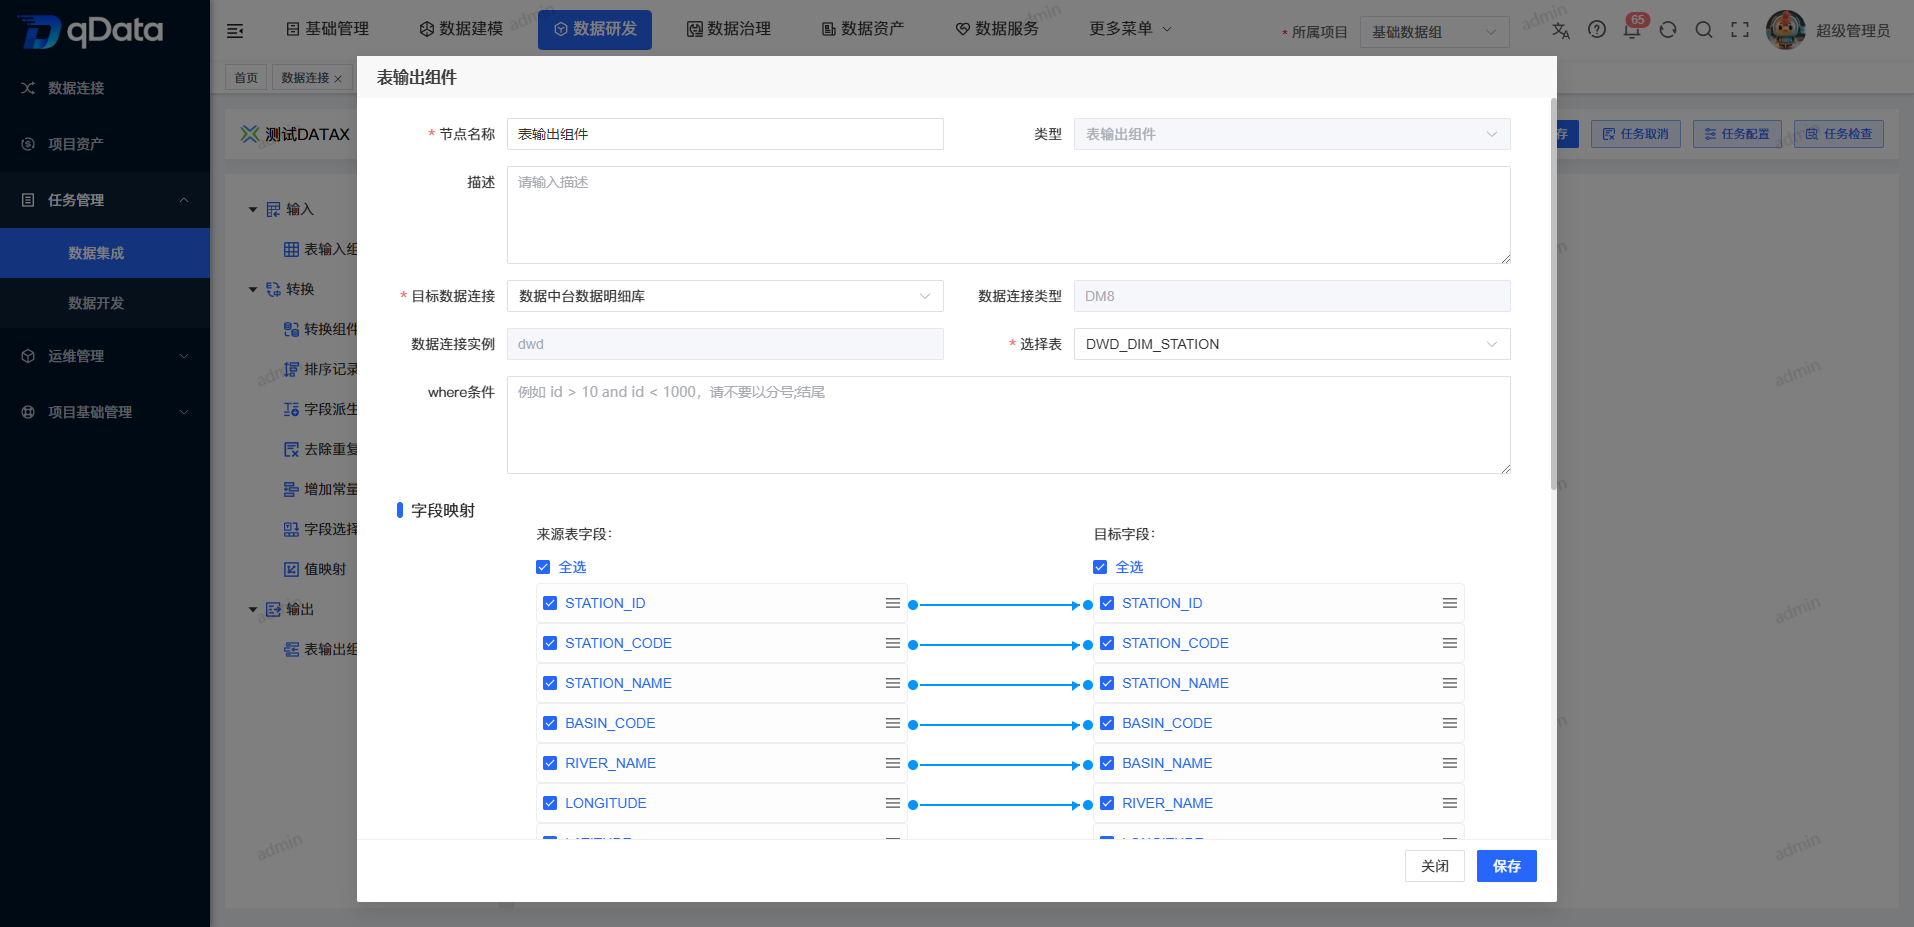
表出力コンポーネント
表出力コンポーネントでは、ターゲット接続、データベース、表、書込方式、項目マッピングを設定します。
タスクを編集する
対象タスクの【編集】をクリックし、基本情報、実行資源、同期フロー、スケジューリング設定を修正して保存します。
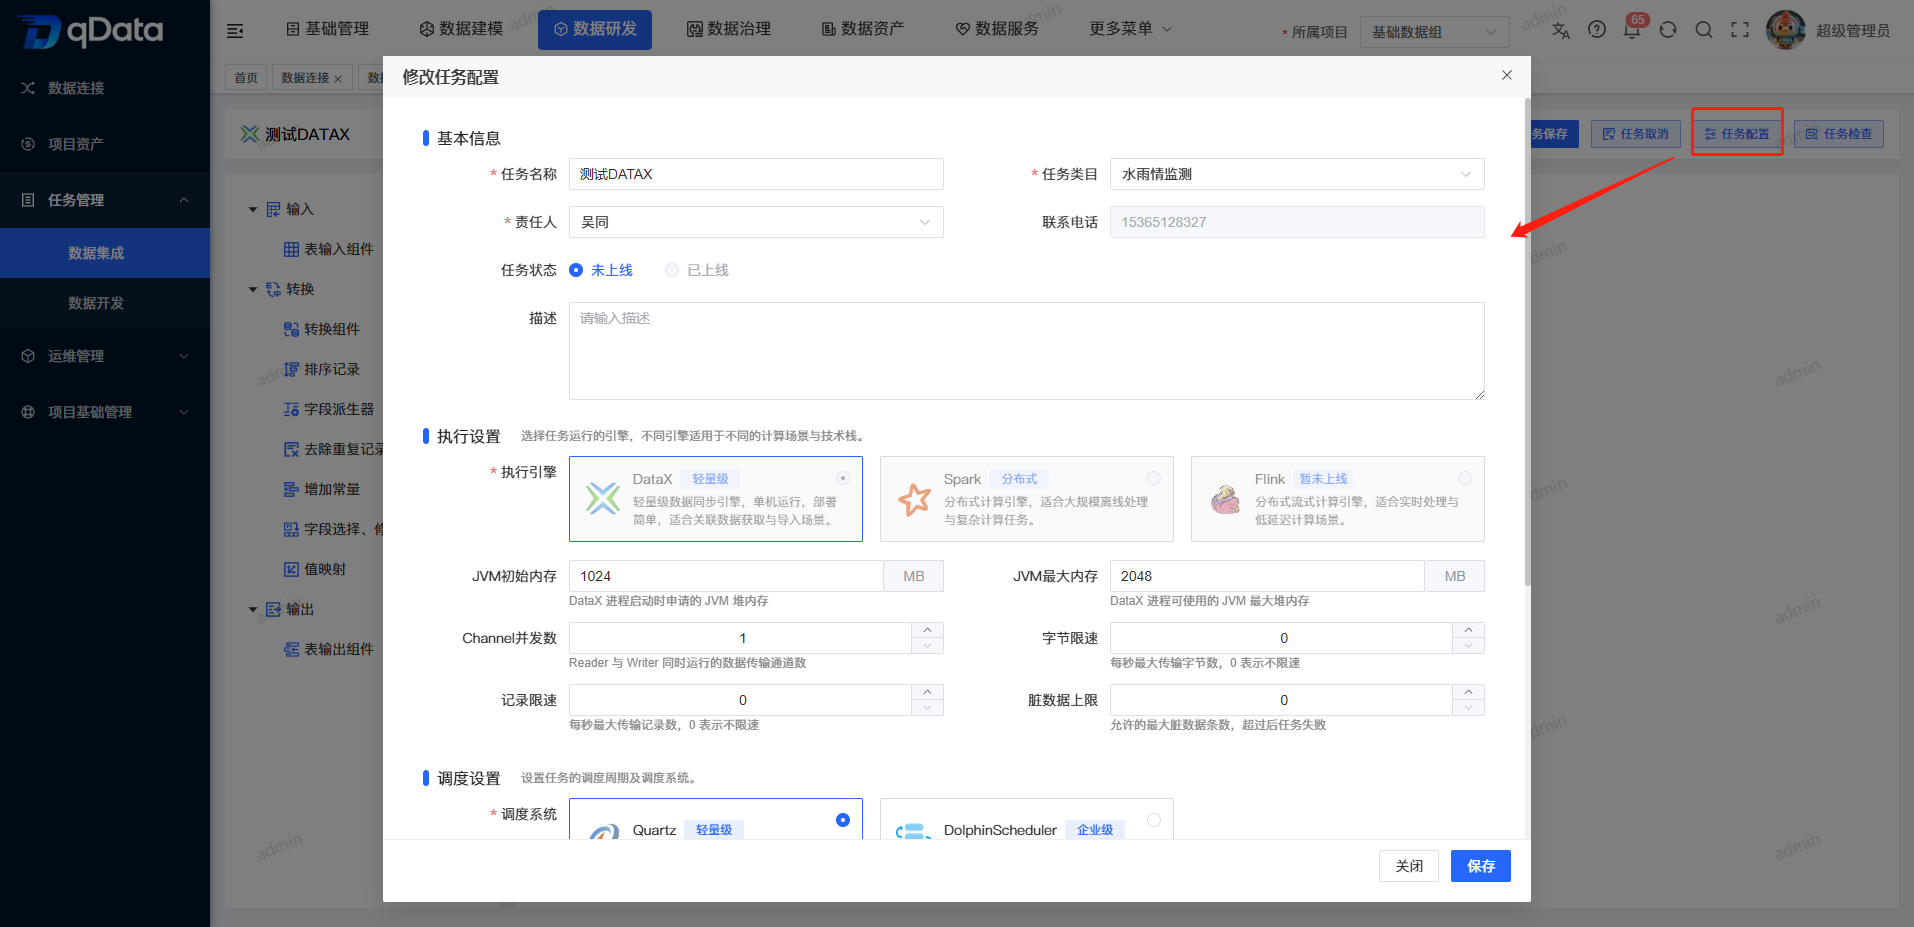
タスク詳細を確認する
対象タスクの【詳細】をクリックすると、タスク設定、フロー、実行情報を確認できます。
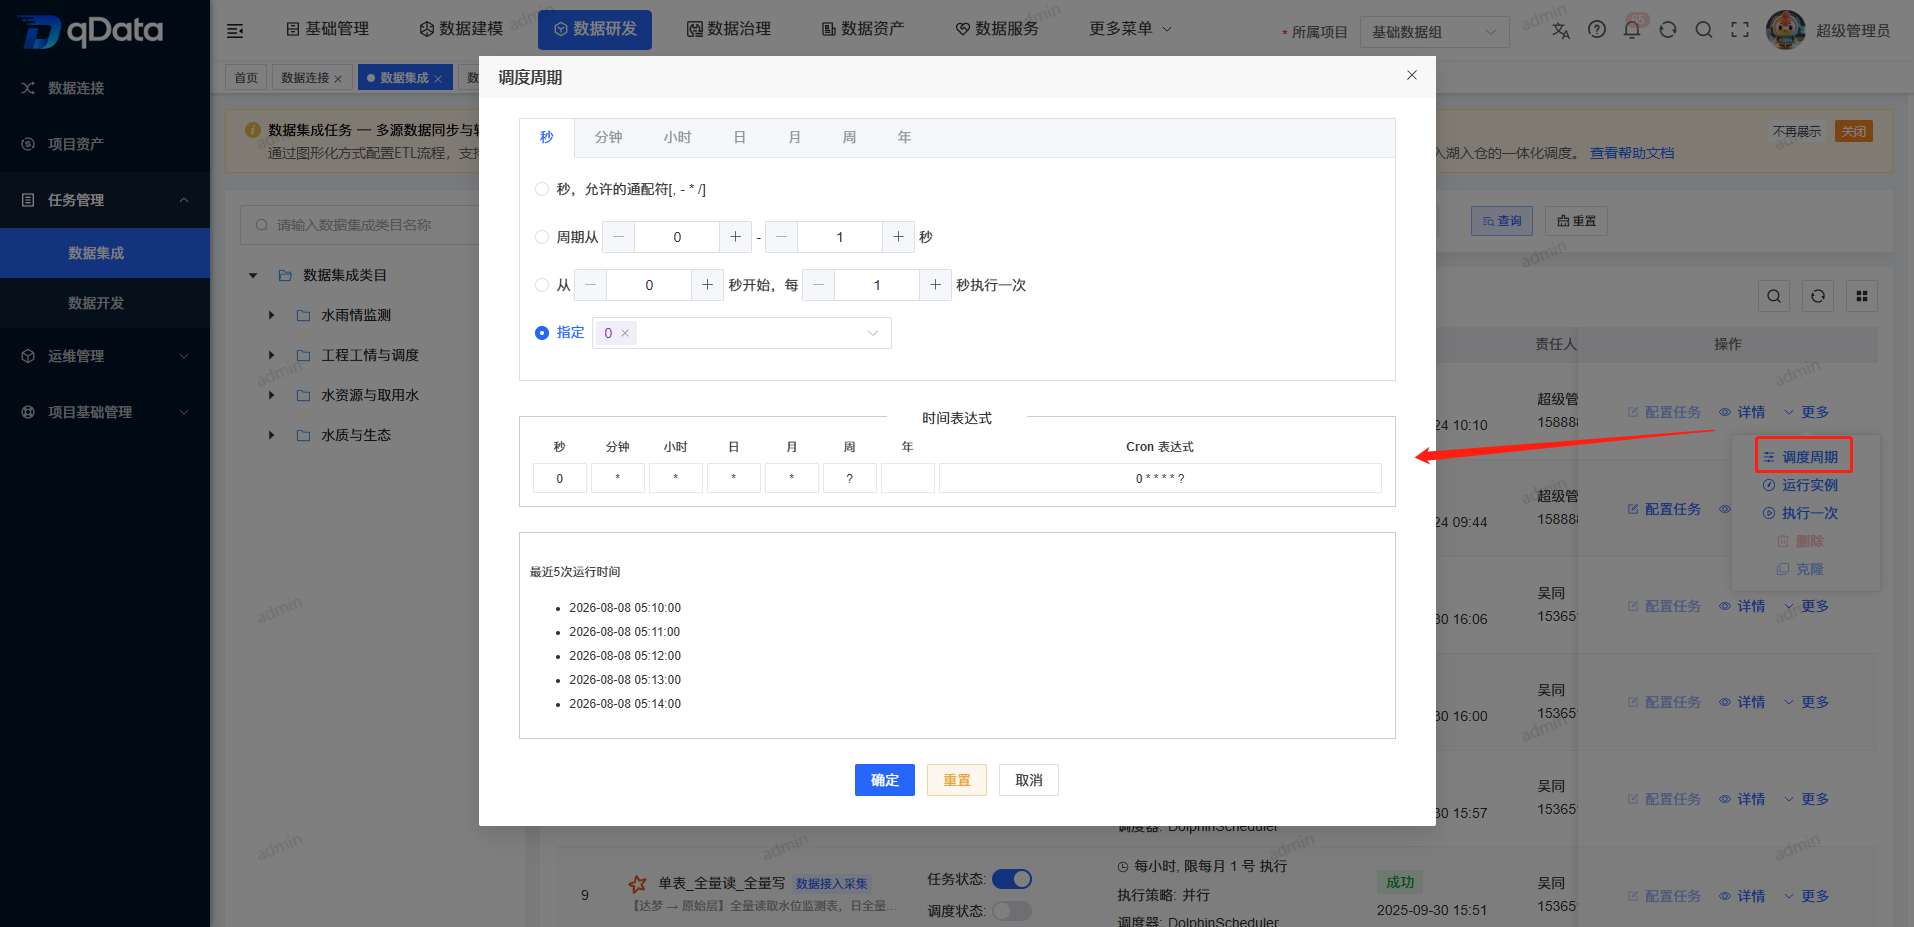
スケジュール周期を設定する
定時実行が必要な場合は、周期、開始時間、終了時間、Cron などの設定を行います。
タスクを公開し、スケジューリングを有効化する
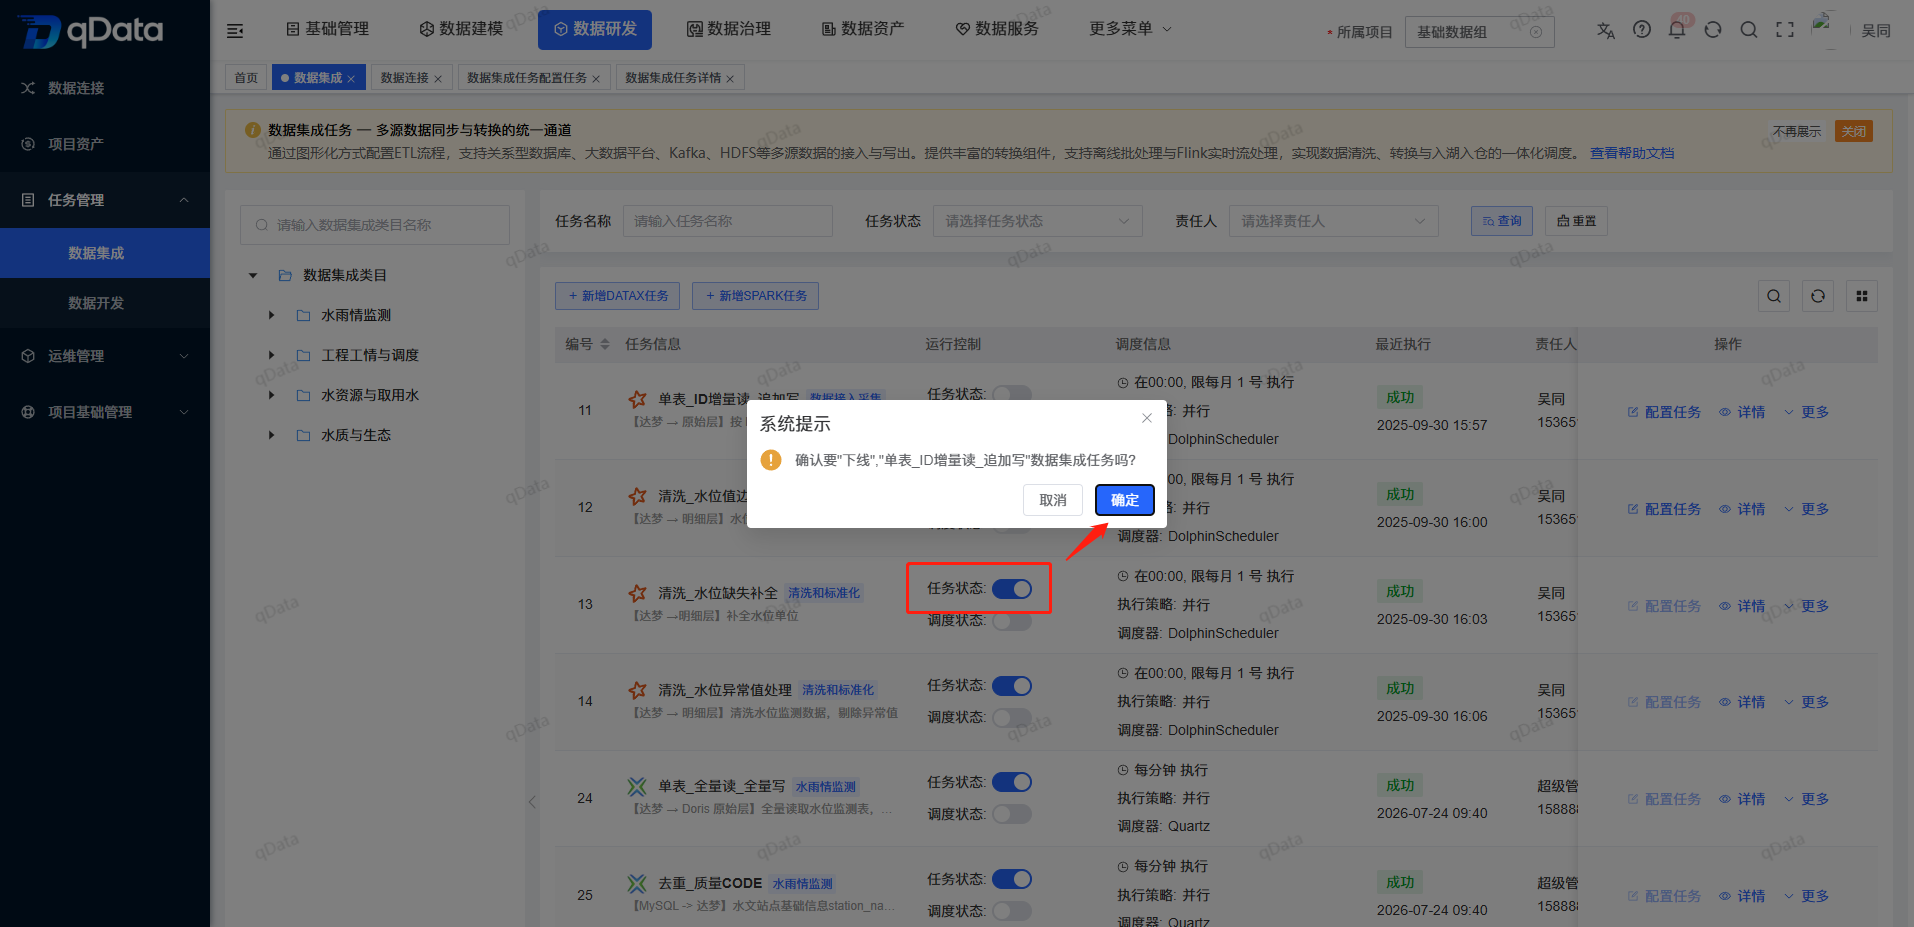
タスク状態
タスクを公開すると、タスクが実行可能な状態になります。公開前に設定が完全であることを確認してください。
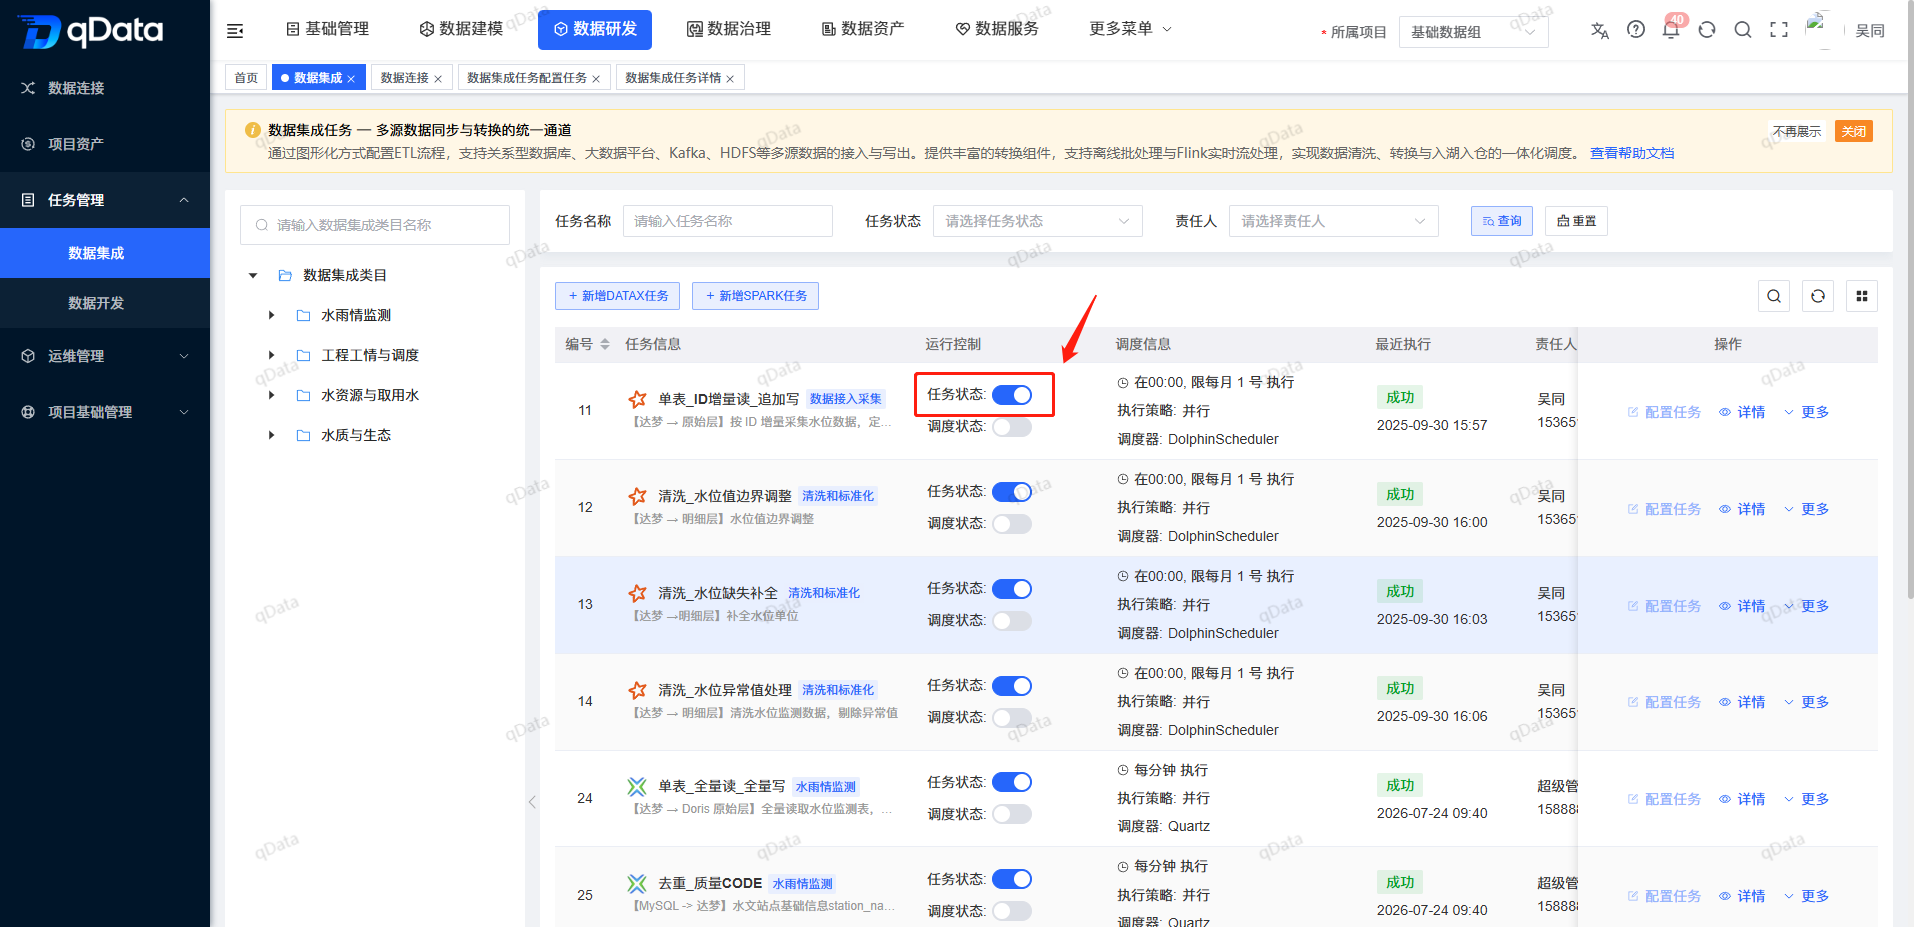
スケジュール状態
スケジュール状態を有効化すると、設定した周期に従って自動実行されます。無効化すると自動実行は停止します。
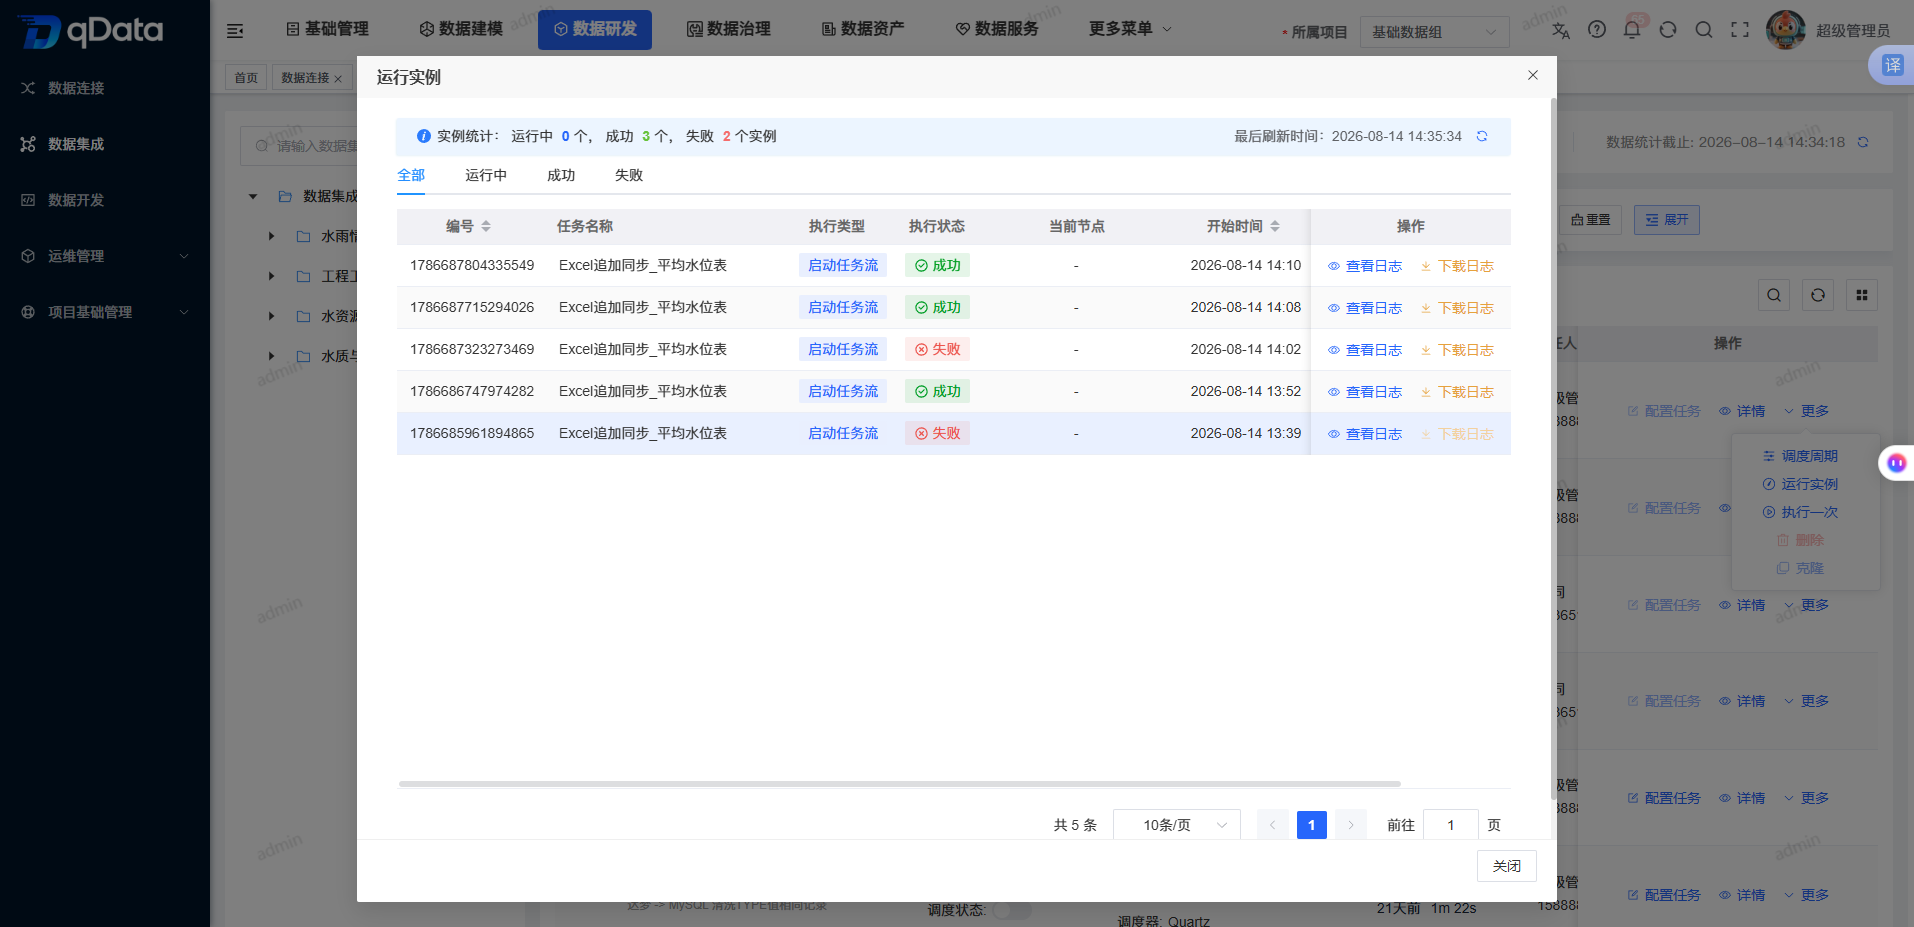
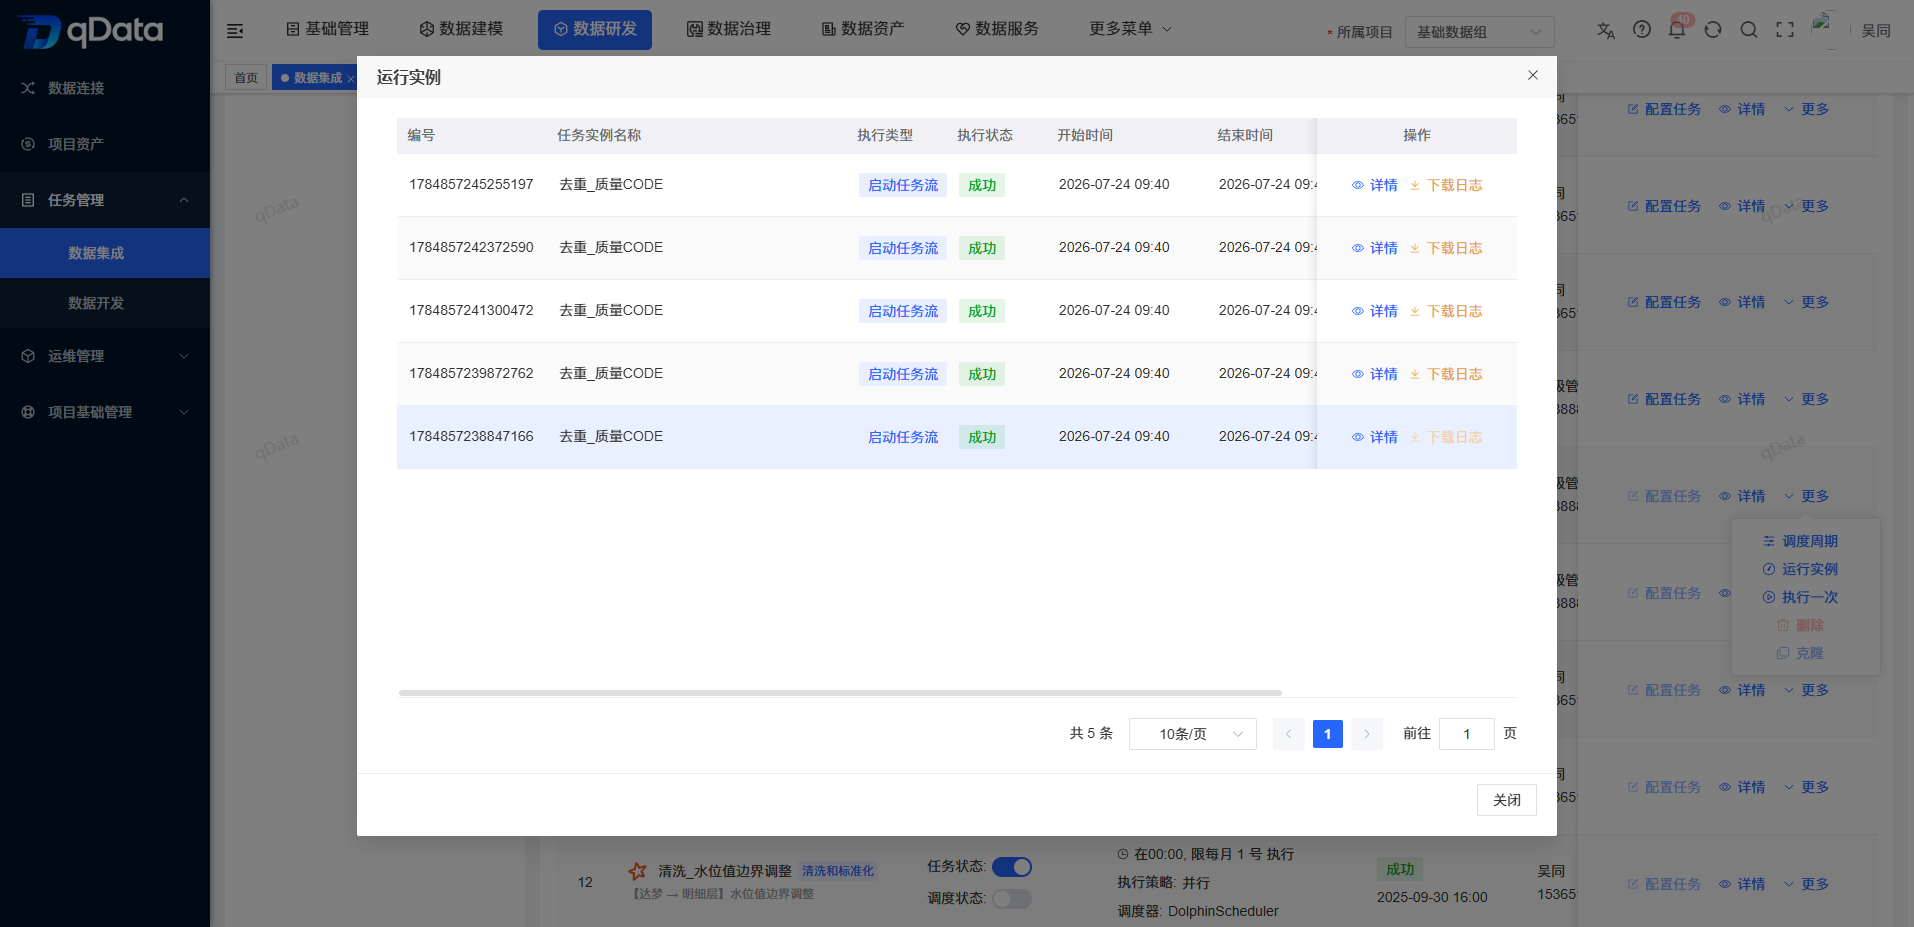
実行インスタンス
対象タスクの実行インスタンスを確認し、実行状態、実行時間、処理結果を追跡できます。
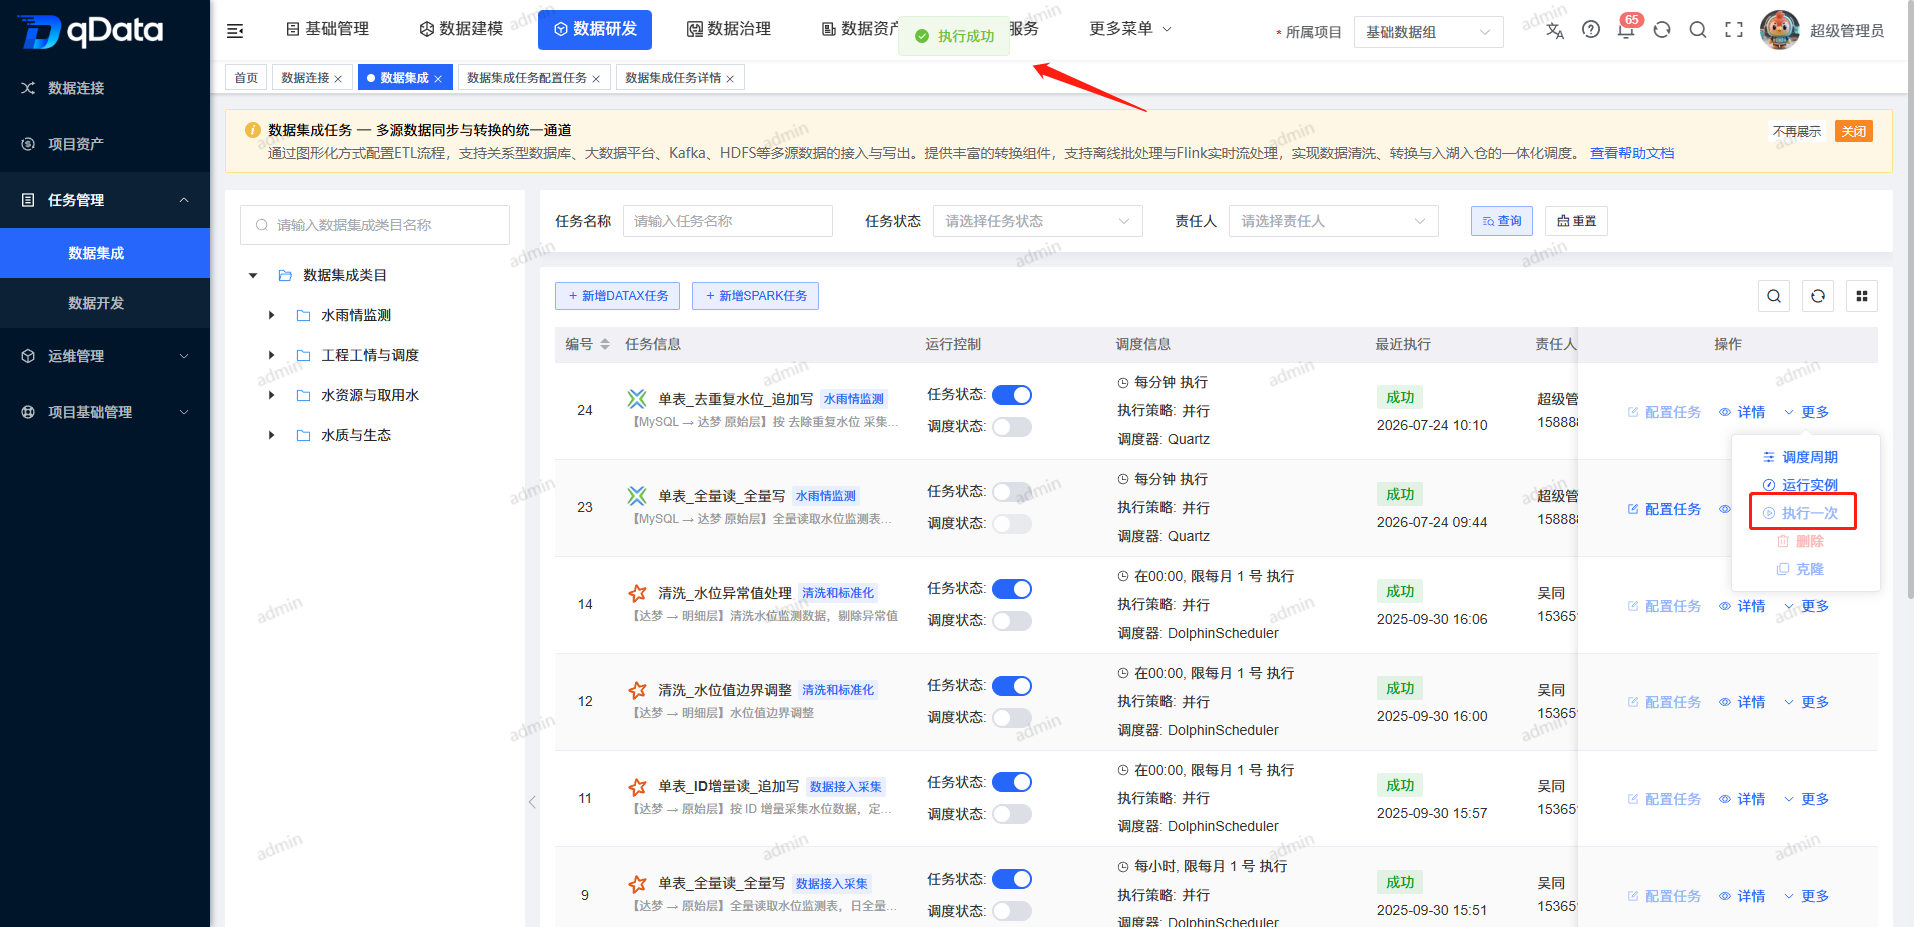
1 回実行
対象タスクの【1 回実行】をクリックすると、現在設定に基づいて即時実行できます。
タスクをクローンする
既存タスクの【クローン】をクリックすると、設定を複製して新しいタスクを作成できます。
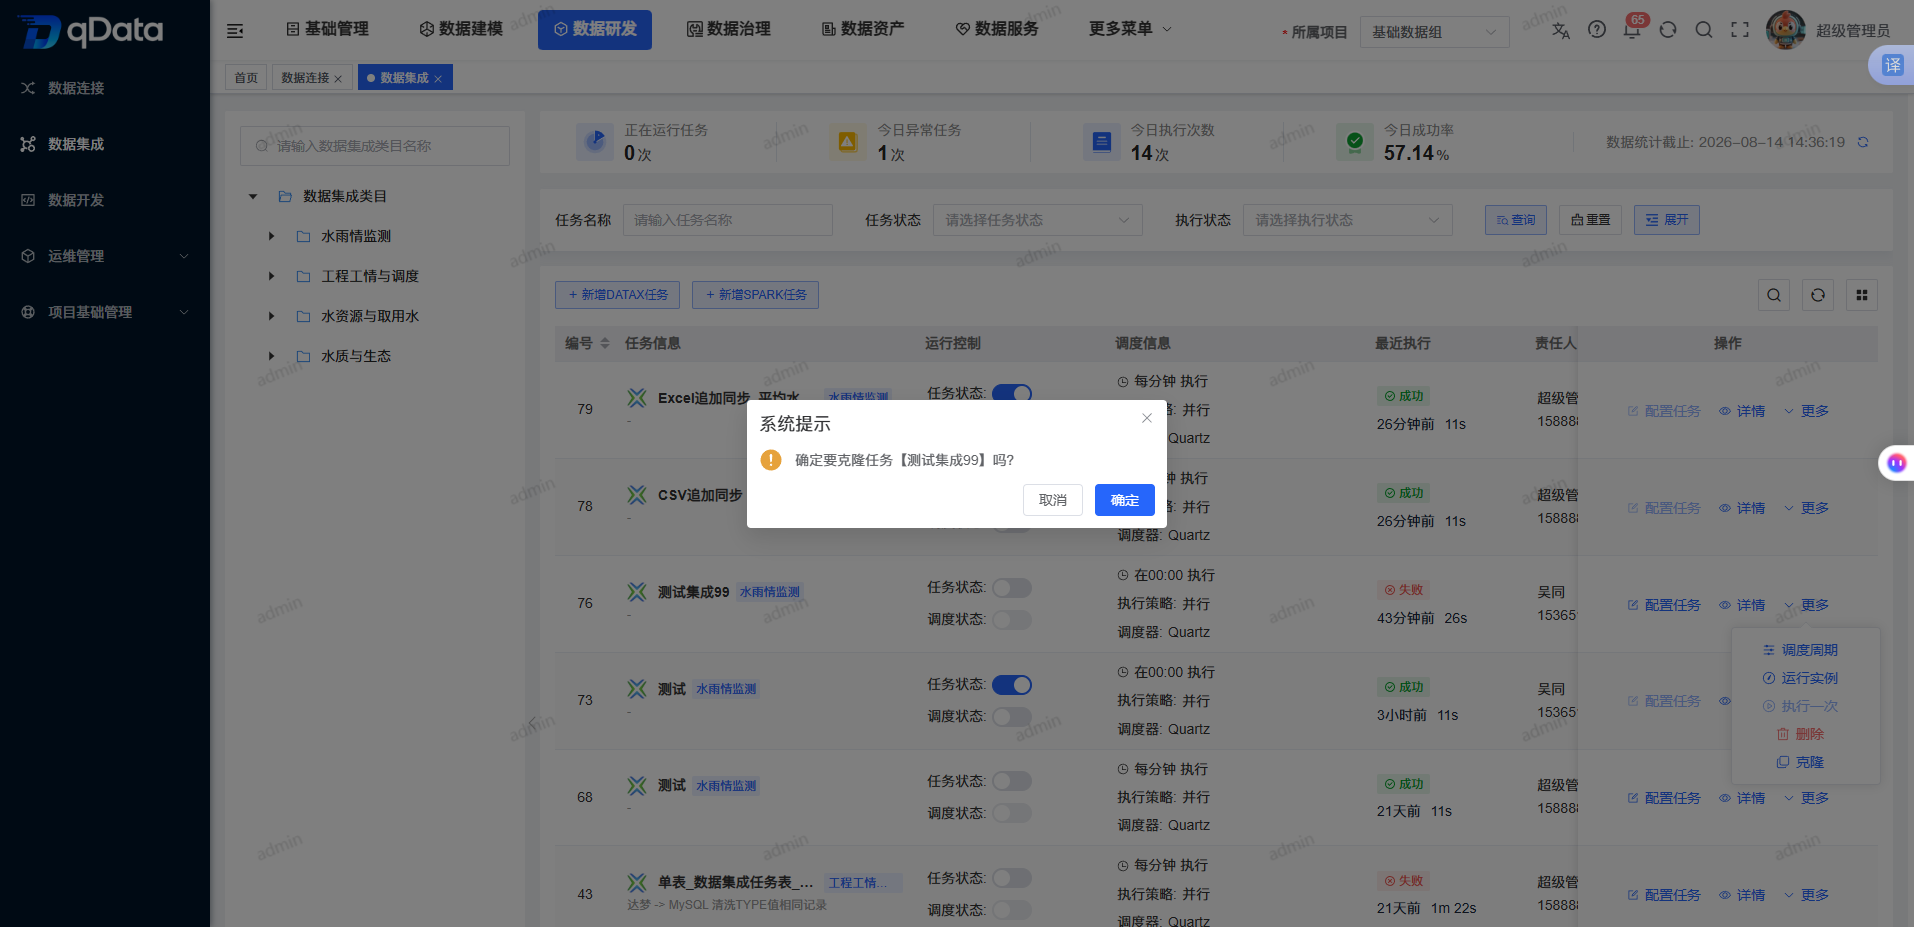
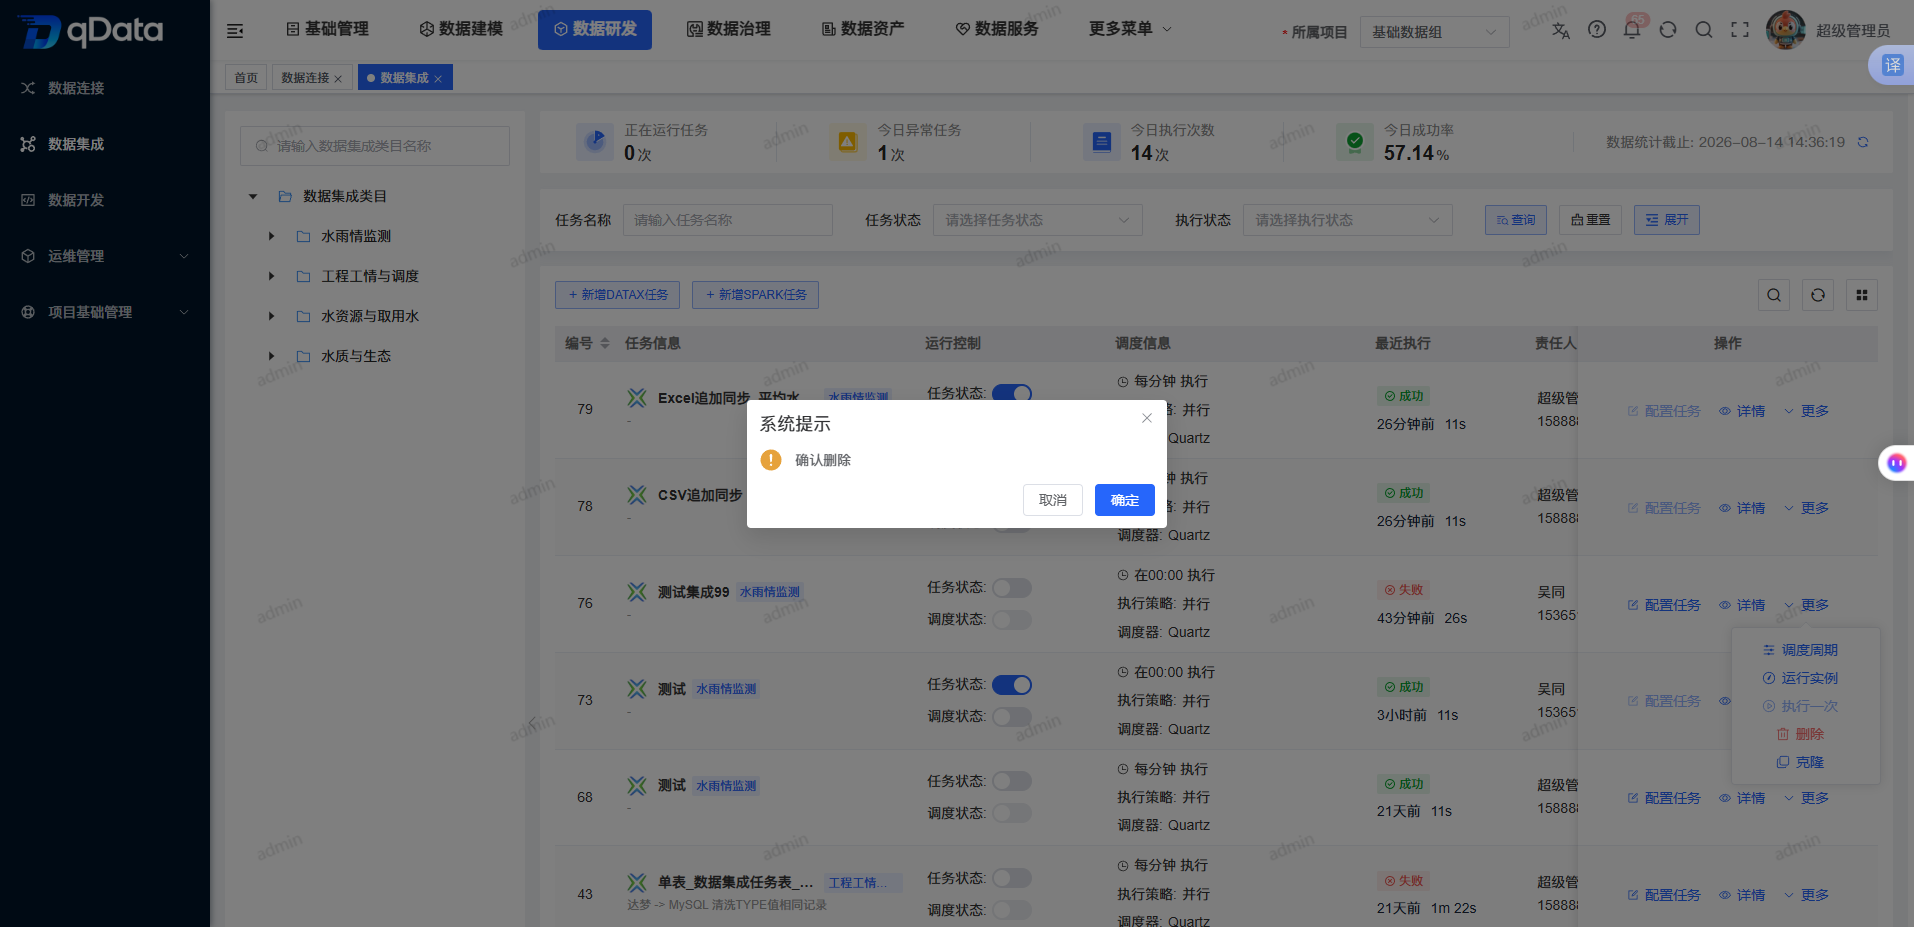
タスクを削除する
不要なタスクの【削除】をクリックし、確認後に削除します。実行履歴や下流参照への影響を事前に確認してください。
よくある質問
- DataX と Spark はどう選択しますか?
軽量な表間同期は DataX、大規模データや分散処理が必要な場合は Spark を選択します。 - スケジュールを有効化しても実行されない場合は?
タスク状態、スケジュール状態、周期設定、実行資源を確認してください。 - 同期失敗の原因はどこで確認しますか?
実行インスタンスとログで確認します。
まとめ
データ統合タスクは、DataX と Spark を使って異種データソース間の同期を管理します。設定時は、実行器タイプ、入力、変換、出力、スケジューリング、実行インスタンスを重点的に確認してください。