数据集成
功能概览
功能定位
数据集成用于在当前项目内创建和管理 ETL 任务,将不同来源的数据接入后,通过可视化流程完成转换、清洗和输出,并统一维护任务运行资源、调度周期、执行实例与日志。
简单理解:把“数据从哪里来、怎样处理、送到哪里”编排成一条可以检查、保存、调度和追踪结果的任务流程。
使用建议
建议先在任务未上线时完成基本信息、运行资源和画布配置,通过【任务检查】并正式保存后再将任务上线;任务上线后才能启用调度或使用【执行一次】。
主要特性
- 项目内任务管理:按当前项目的数据集成类目查询、创建和维护任务。
- DataX 轻量级同步:支持 MySQL、DM8、人大金仓、Oracle、Doris 等多类数据源,适合中小表全量或增量离线同步。
- Spark 分布式同步:支持分布式并行读取与批处理,适合大规模离线数仓建设。
- 可视化流程编排:通过输入、转换、输出等组件拖拽配置同步流程。
- 调度与单次执行:根据任务状态启用调度或发起一次执行。
- 实例与日志追踪:通过运行实例查看执行状态、时间、责任人和执行日志。
- 任务维护保护:上线任务不能修改、删除或克隆;被作业引用的任务不能删除。
DataX 轻量级能力
- ✅ 内置全类型数据源适配插件,兼容 MySQL、DM8、人大金仓、Oracle、Doris 等多类国产与通用数据库,开箱即用,无需额外驱动部署;
- 🔁 支持 JVM 内存、通道并发、字节与记录双层限流、脏数据阈值精细化管控,可灵活调节同步吞吐量,规避源库压力过载;
- 🧩 单机轻量化架构无集群依赖,启动速度快、运维简单,适配千万级以内中小表全量或增量离线同步场景。
Spark 分布式能力
- ✅ 分布式并行分片读取能力,突破单机算力和内存瓶颈,适合大规模历史数据批处理同步;
- 🔁 同步与复杂计算一体化,支持多表关联、聚合、分区重写等批处理算子,可在数据搬运过程中完成清洗加工;
- 🧩 复用大数据集群资源隔离调度,支持超大分区表、归档历史数据和数仓分层场景,适合大规模离线数仓建设。
作用范围
本功能适用于当前项目内的数据集成任务创建、运行配置、流程编排、状态控制、调度执行和实例查询。用户能够执行的操作由当前项目角色授权决定。切换项目后,页面重新加载目标项目的数据集成类目、任务范围和角色授权。
前置步骤
前置条件
- 已登录 qData 平台,并具备当前项目的【数据集成】菜单访问权限。
- 已切换到需要维护任务的正确项目。
- 当前项目已维护可选的数据集成类目和责任人。
- 已准备任务所需的数据连接、执行引擎和运行资源。
- 如需使用 Yarn 队列,已确认对应队列资源可用。
导航路径
数据研发 > 数据集成
页面总览
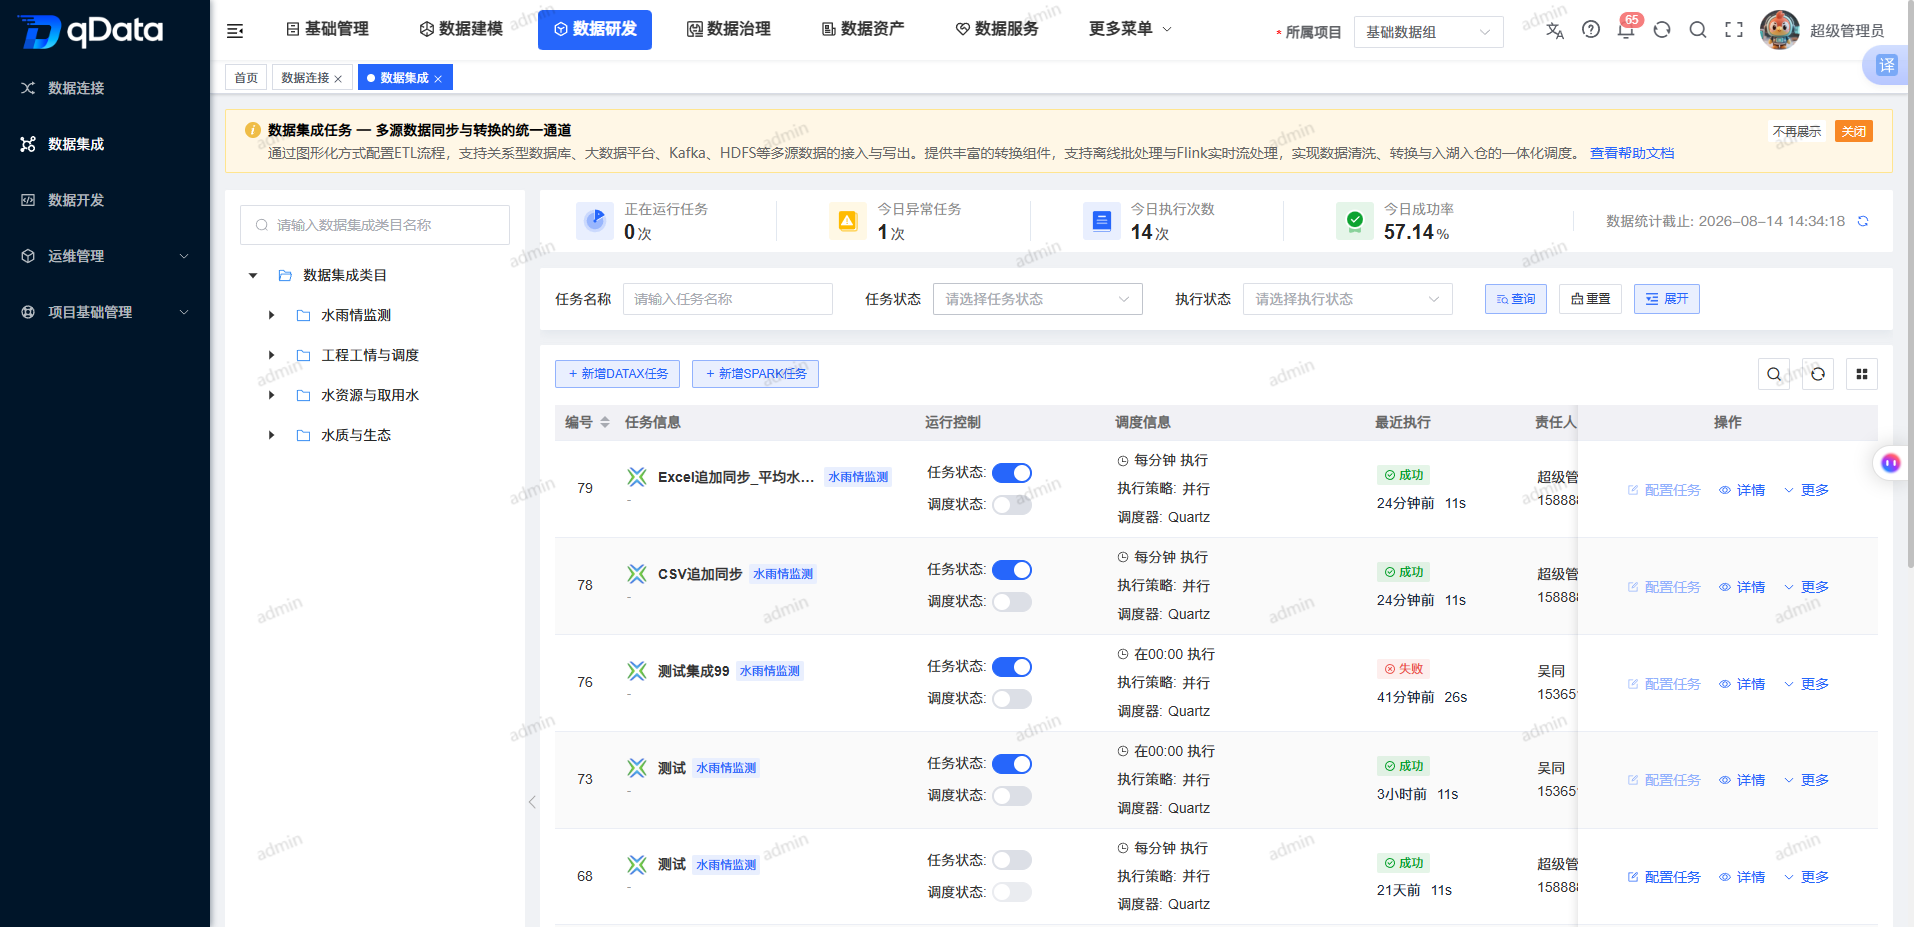
进入数据集成页面后,左侧为数据集成类目搜索与类目树,顶部展示任务执行统计情况和查询区提供任务名称、任务状态和执行状态筛选,右侧列表展示任务信息、所属类目、任务状态、调度状态、策略与调度、责任人、创建人、创建时间及操作入口。
每条任务提供【配置任务】【详情】【更多】;【更多】菜单包含【调度周期】【运行实例】【执行一次】【删除】【克隆】等操作。
推荐操作流程
新建 DataX 任务:进入页面 → 点击【新增DATAX任务】 → 配置基础信息与运行参数 → 点击【确定】 → 点击【配置任务】 → 配置输入、转换、输出组件 → 保存同步流程 → 将任务上线 → 启用调度或【执行一次】 → 查看运行实例与日志。
修改任务:如调度已启用,先关闭调度 → 将任务下线 → 修改任务或流程 → 保存配置 → 重新上线 → 按需恢复调度。
问题排查:核对任务状态和调度状态 → 进入【运行实例】查看执行状态 → 查看任务日志定位失败原因。
功能操作说明
查询和定位任务
- 在左侧类目树中选择目标数据集成类目。
- 顶部展示任务执行统计,包含正在运行、今日异常、今日执行次数、今日成功率。
- 在查询区填写任务名称、任务状态、执行状态或时间。
- 点击【查询】刷新任务列表。
- 点击【重置】清空或恢复查询条件。
- 在列表中核对任务状态、调度状态、执行策略和责任人。
新增 DataX 数据集成任务
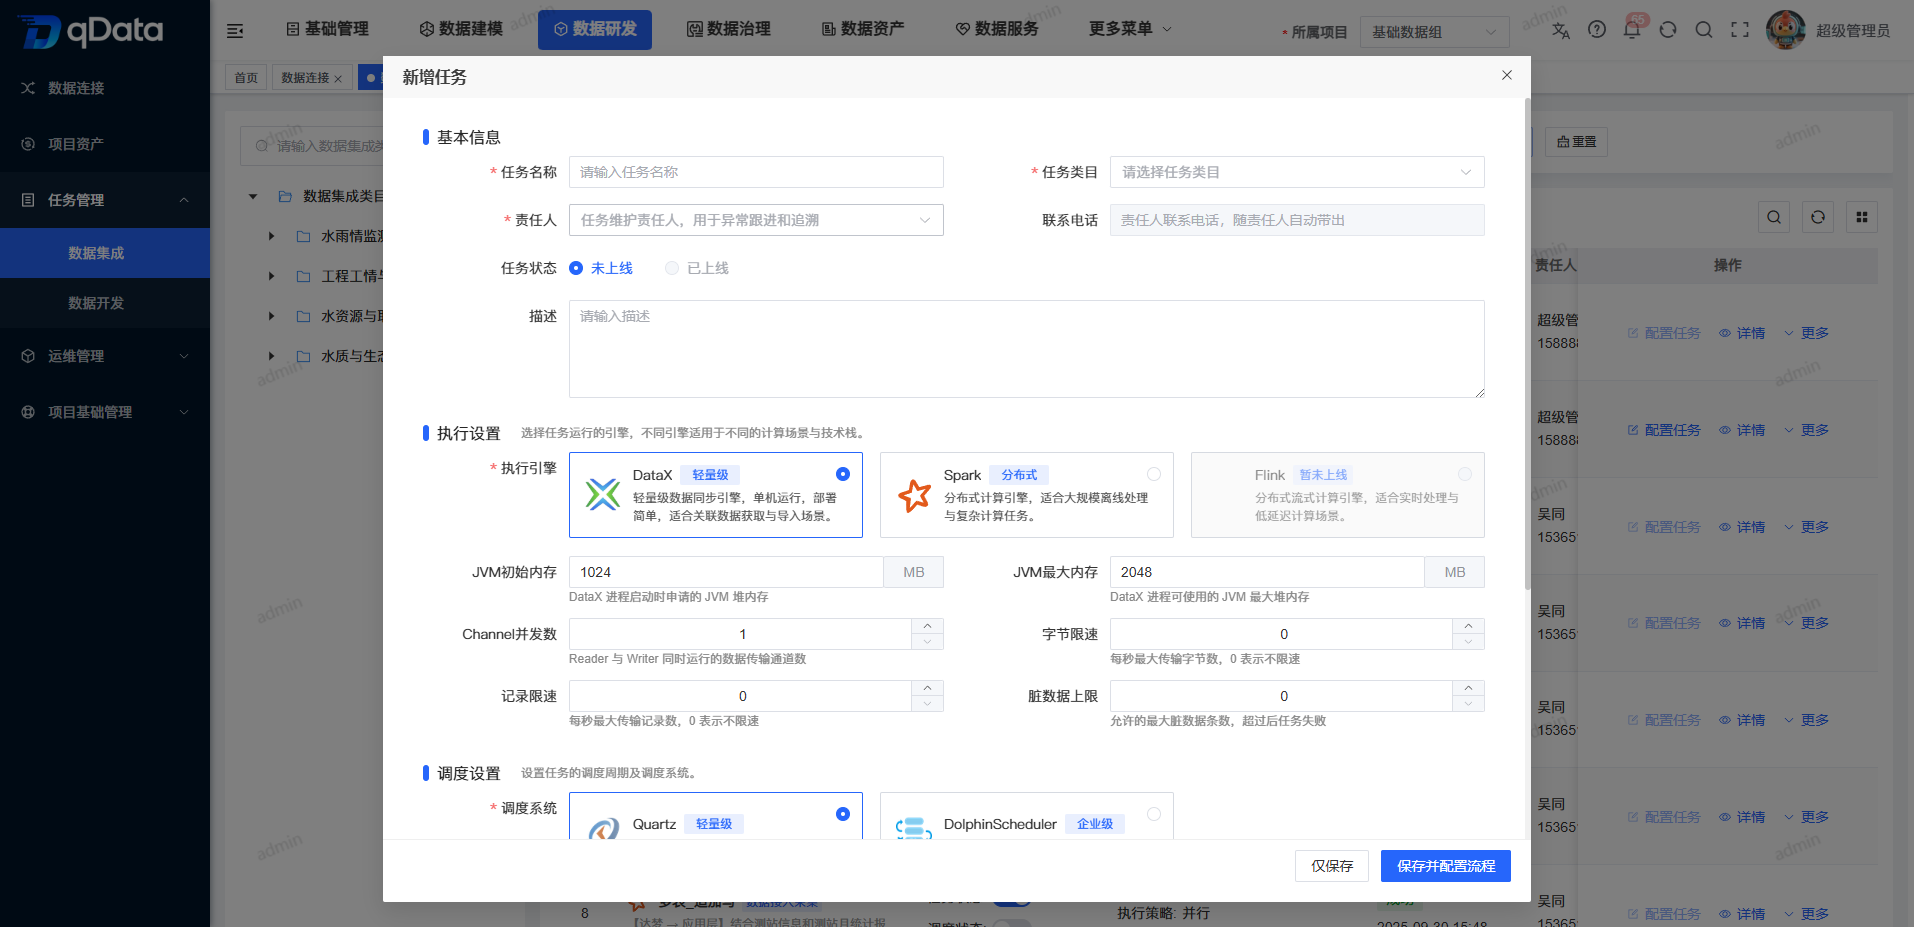
- 点击页面中的【新增DATAX任务】按钮。
- 在弹出框内填写任务名称、任务类目、责任人、描述等基础信息。
- 在执行配置中选择或确认 DataX(轻量级)。
- 按业务需要配置执行策略、调度周期、失败重试等运行参数。
- 点击【确定】完成 DataX 数据集成任务新增。
基本信息
| 字段名 | 说明 | 是否必填 |
|---|---|---|
| 任务类目 | 选择当前项目中的数据集成类目。 | 是 |
| 任务名称 | 填写用于识别任务的名称。 | 是 |
| 执行策略 | 可选并行、串行等待、串行抛弃、串行优先;新增默认并行。 | 是 |
| 调度周期 | 通过 Cron 表达式生成器配置执行周期。 | 是 |
| 责任人 | 选择任务责任人。 | 是 |
| 联系电话 | 随责任人显示,当前为只读。 | 否 |
| 任务状态 | 新增默认未上线,“已上线”选项不可用。 | 否 |
| 描述 | 填写任务用途,页面显示 500 字符计数。 | 否 |
| 备注 | 填写补充说明,页面显示 500 字符计数。 | 否 |
运行参数与执行资源
| 字段名 | 说明 | 是否必填 |
|---|---|---|
| 任务优先级 | 可选 HIGH、HIGHEST、MEDIUM、LOW、LOWEST。 | 否 |
| 失败重试次数 | 任务失败后的重试次数,单位为“次”。 | 否 |
| 失败重试间隔 | 相邻重试之间的间隔,单位为“分”。 | 否 |
| 延迟执行时间 | 任务延迟执行时长,单位为“分”。 | 否 |
| Worker 分组 | 默认 default,当前为只读。 | 否 |
| 执行引擎 | 可选 DataX、SPARK;DataX 适用于轻量级离线同步,SPARK 适用于分布式批处理同步。 | 否 |
| Yarn 队列 | 任务使用的 Yarn 队列;使用 SPARK 执行时按集群资源配置。 | 否 |
- DataX 资源:重点关注 JVM 内存、通道并发、字节限流、记录限流和脏数据阈值等参数,按源库承载能力合理配置。
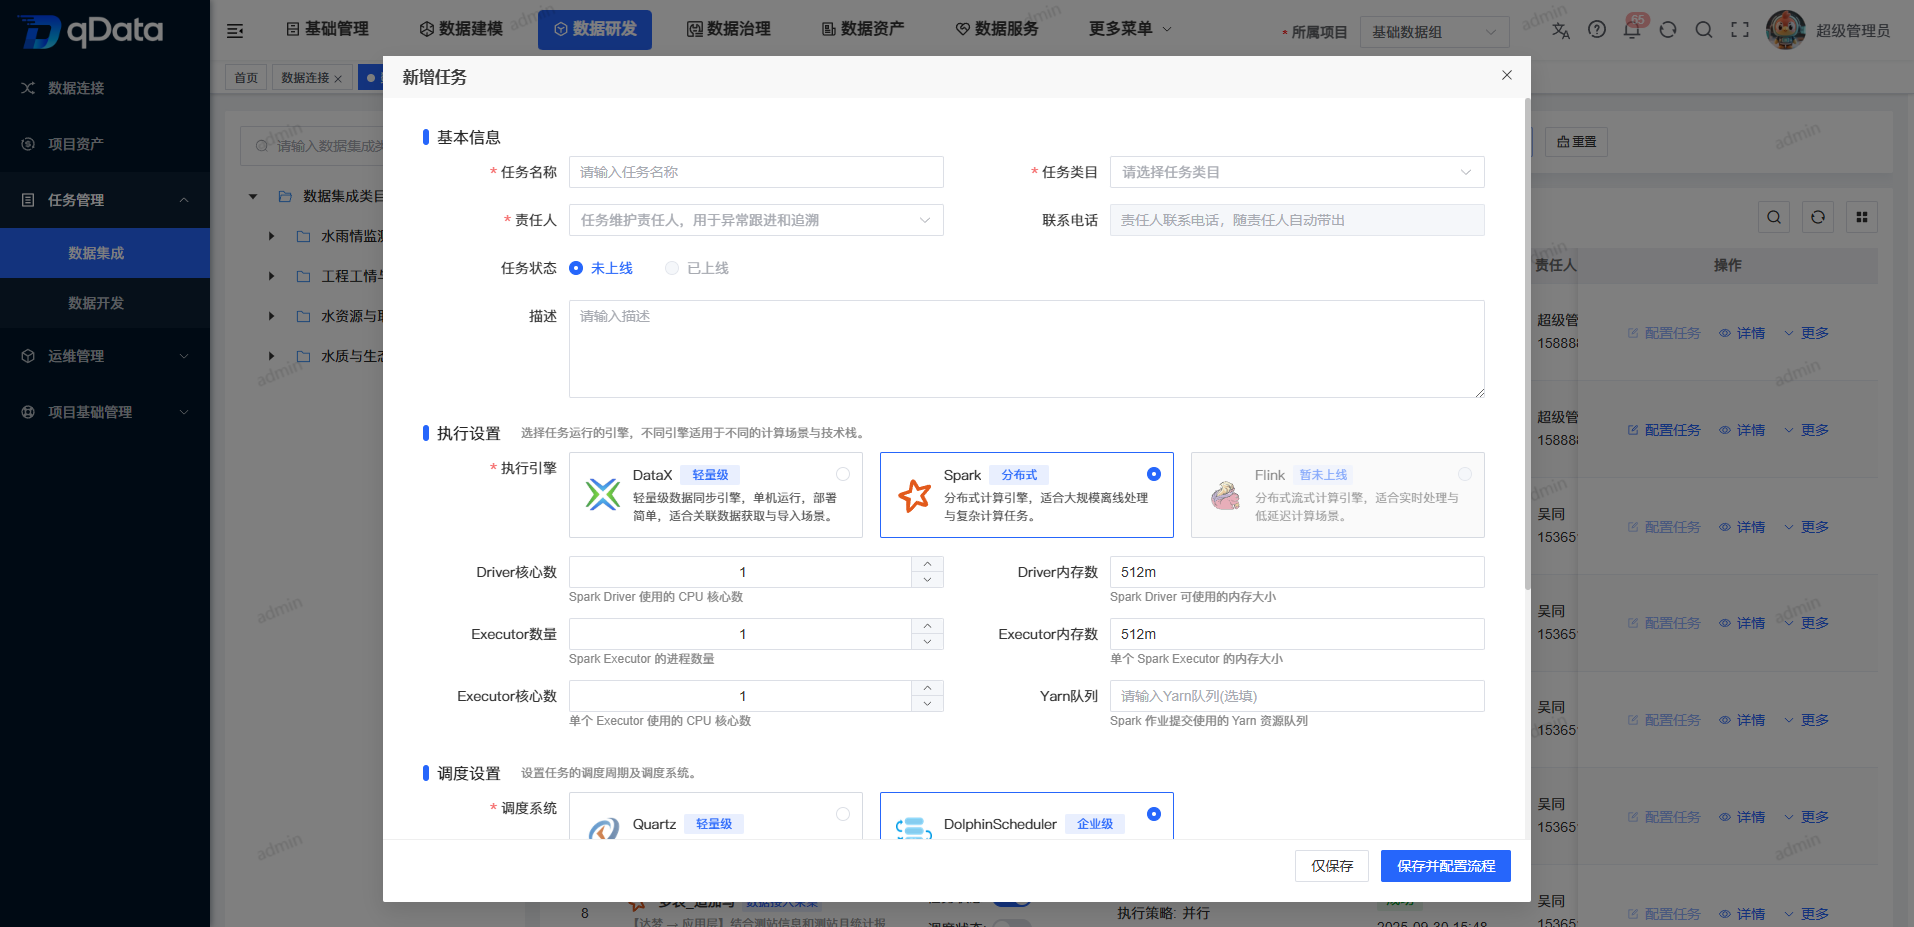
- SPARK 资源:Driver 核心数、Driver 内存数、Executor 数量、Executor 内存数、Executor 核心数。
DataX 适用场景
| 场景 | 说明 |
|---|---|
| 中小表离线同步 | 适合千万级以内数据表的全量或增量同步。 |
| 异构数据库同步 | 支持多类关系型数据库与数仓目标端之间的数据搬运。 |
| 轻量级部署 | 无需依赖大数据集群,适合资源较轻的同步任务。 |
| 吞吐管控 | 可通过并发、限流和脏数据阈值控制同步压力。 |
Spark 适用场景
| 场景 | 说明 |
|---|---|
| 大规模离线同步 | 适合数据量较大、单机 DataX 执行压力较高的批量同步任务。 |
| 分布式批处理 | 适合依赖 Spark 集群资源进行并行读取、转换和写出的任务。 |
| 数仓分层加工 | 适合在同步过程中完成聚合、关联、分区处理等数仓加工逻辑。 |
| 历史数据归档 | 适合大批量历史数据、超大分区表或归档数据写入 Doris、Hive 等目标端。 |
新增 Spark 数据集成任务
如任务需要处理大规模数据或依赖分布式计算资源,可点击【新增Spark任务】创建 Spark(分布式)数据集成任务。
配置同步流程
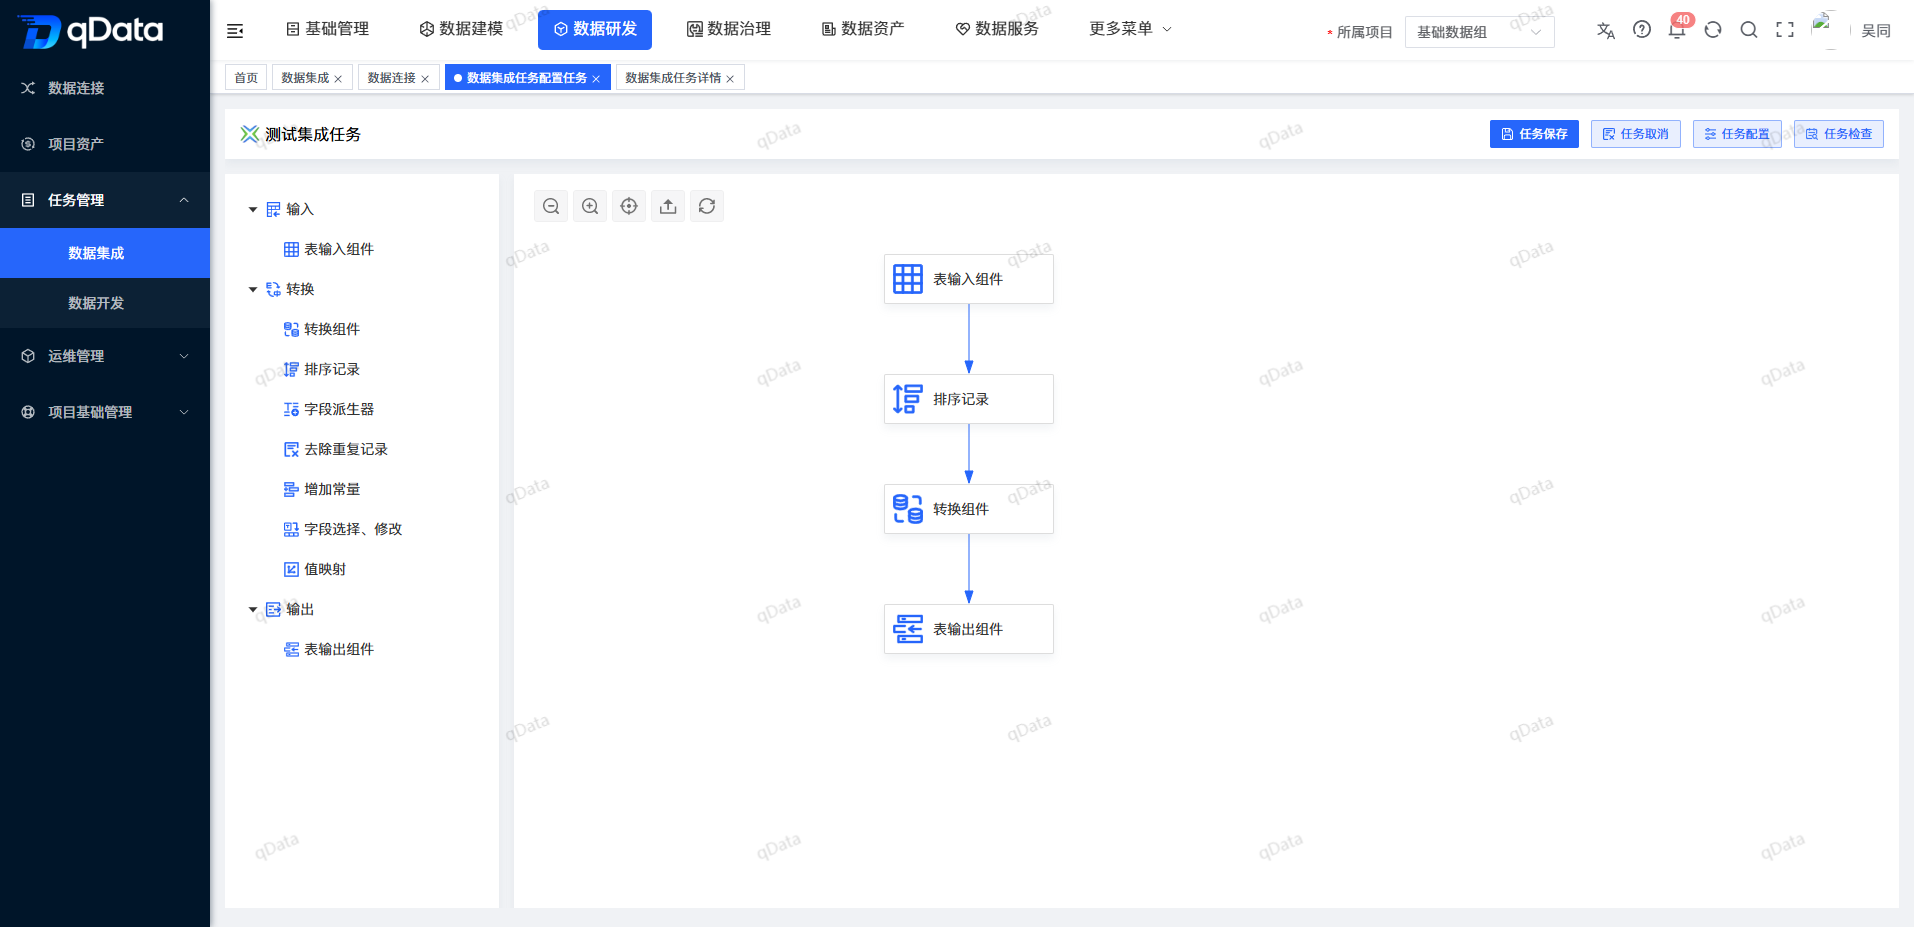
选择需要配置的数据集成任务,在操作列中点击【配置任务】或【配置转化】按钮,进入可视化任务配置页面。用户可在画布中配置输入组件、转换组件和输出组件,并通过连线形成完整同步流程。
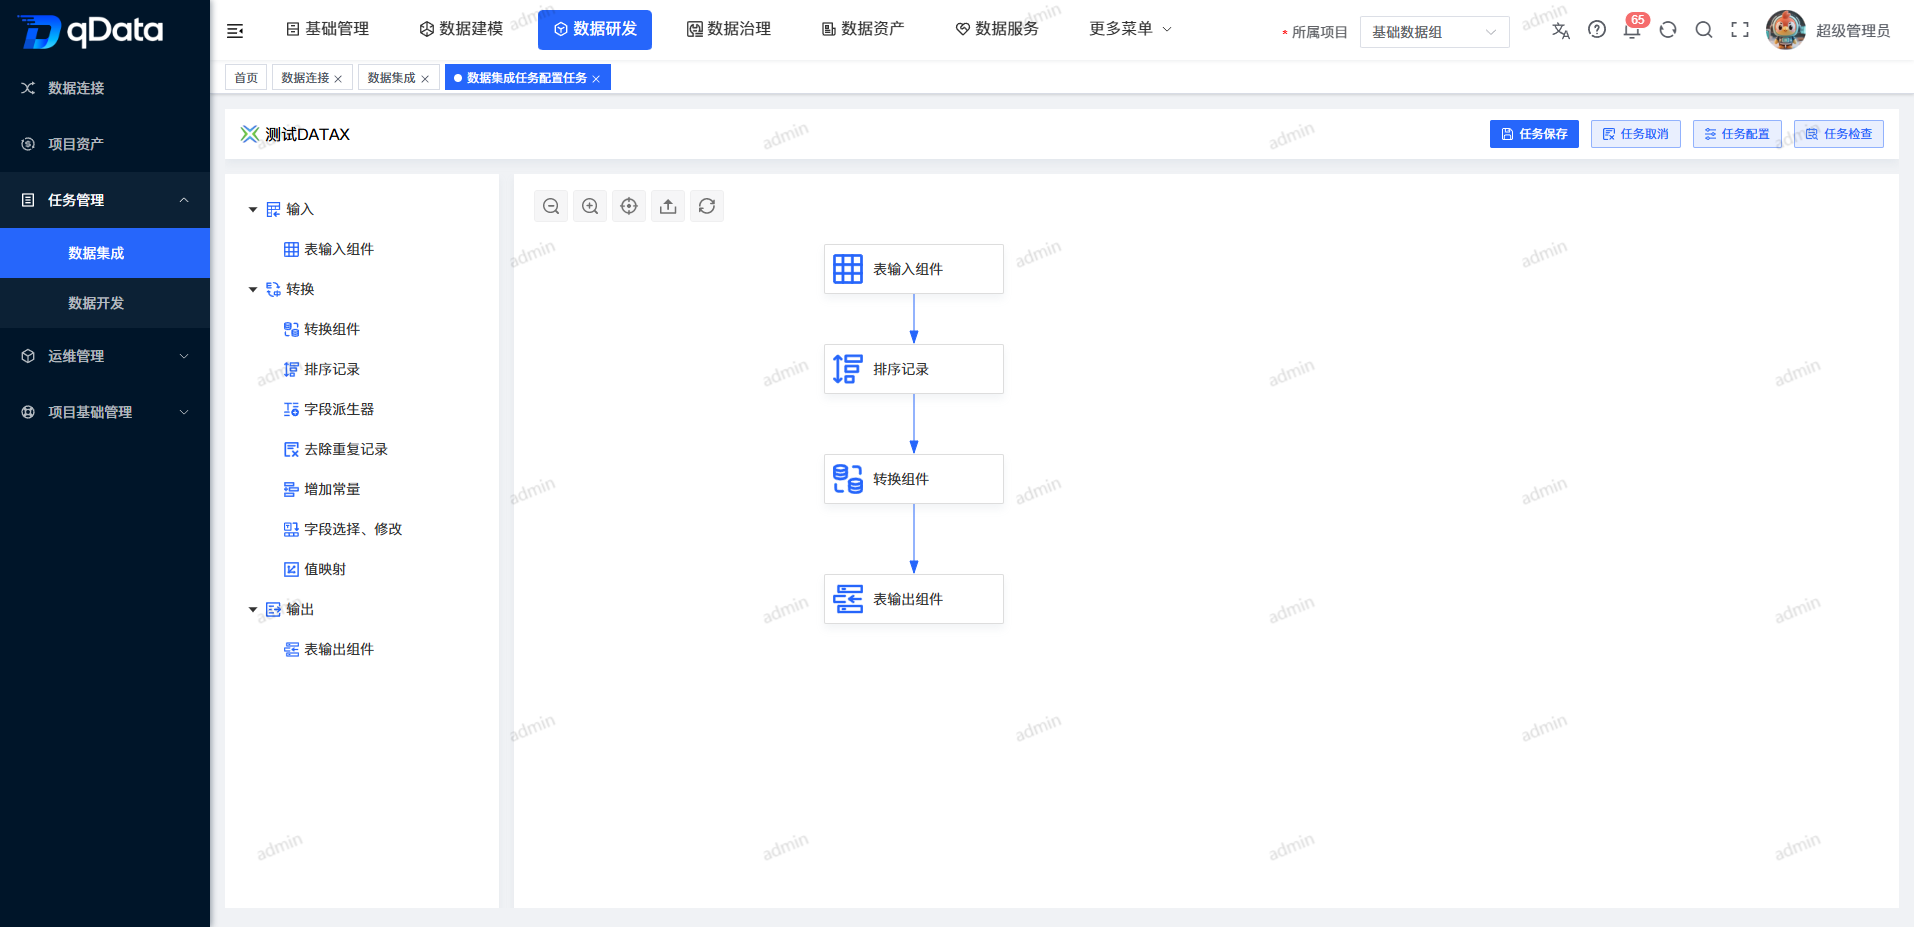
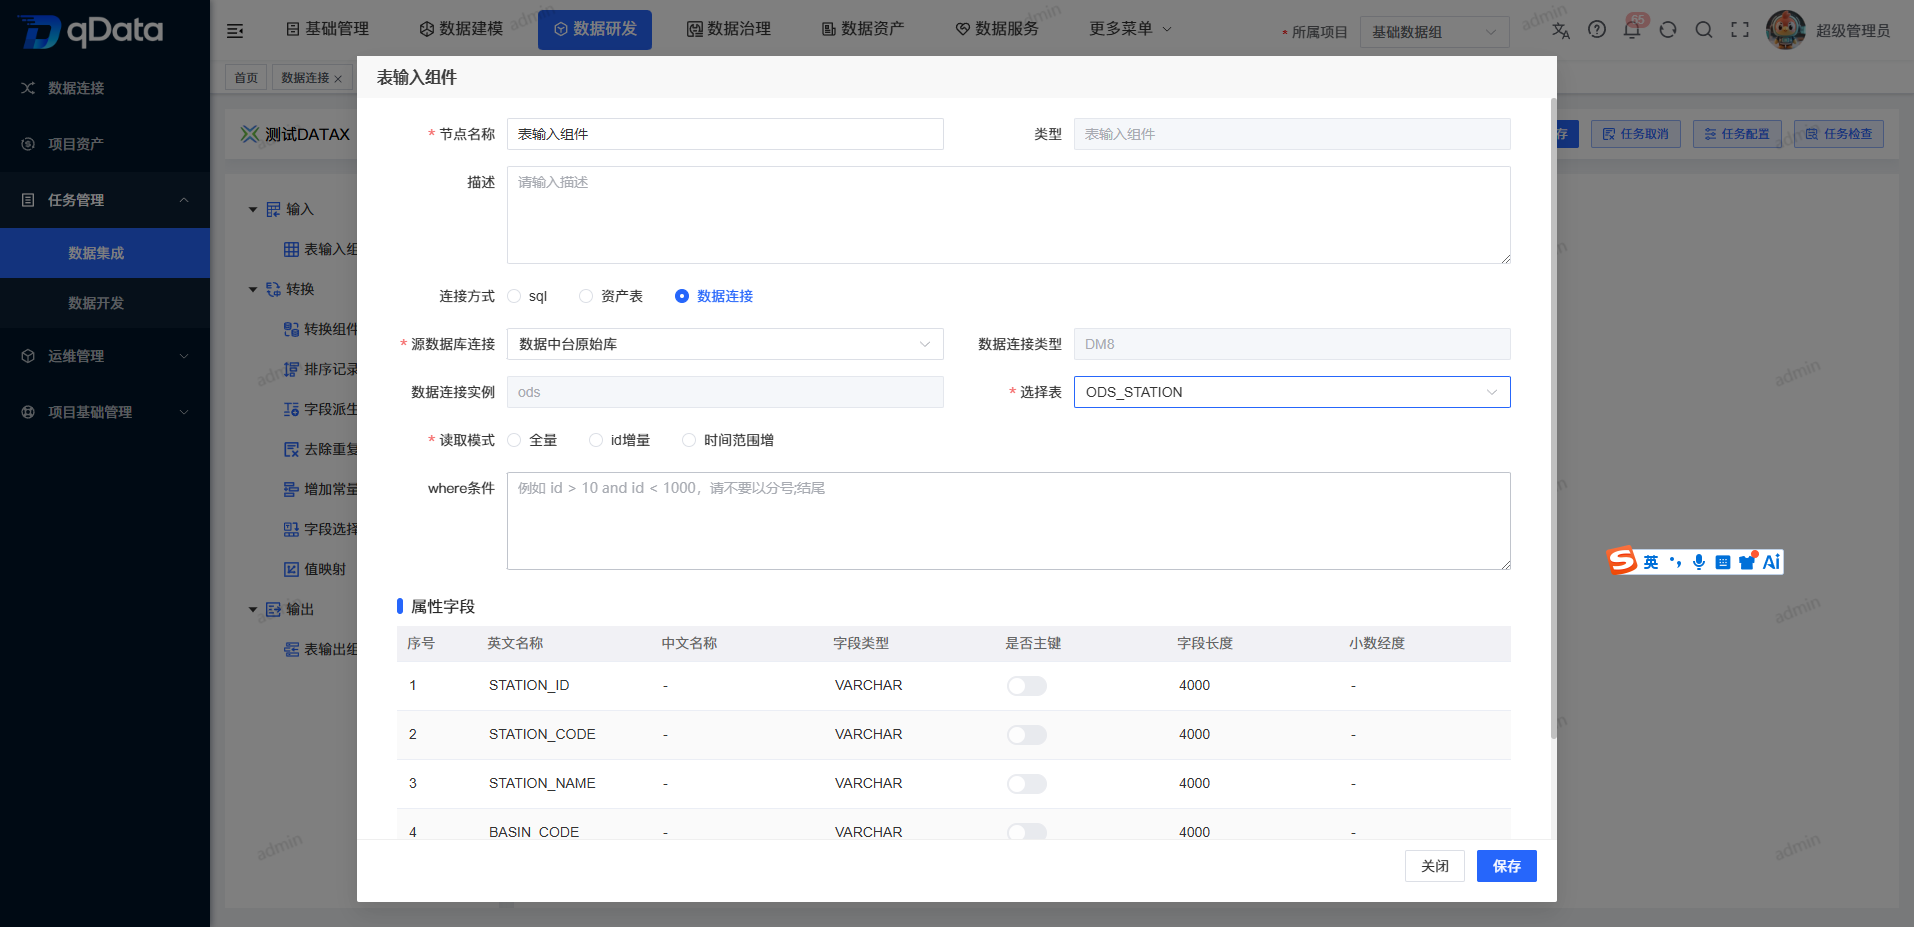
表输入组件
表输入组件用于配置源端数据读取信息,通常需要选择数据连接、库表对象、读取字段、过滤条件和读取方式。
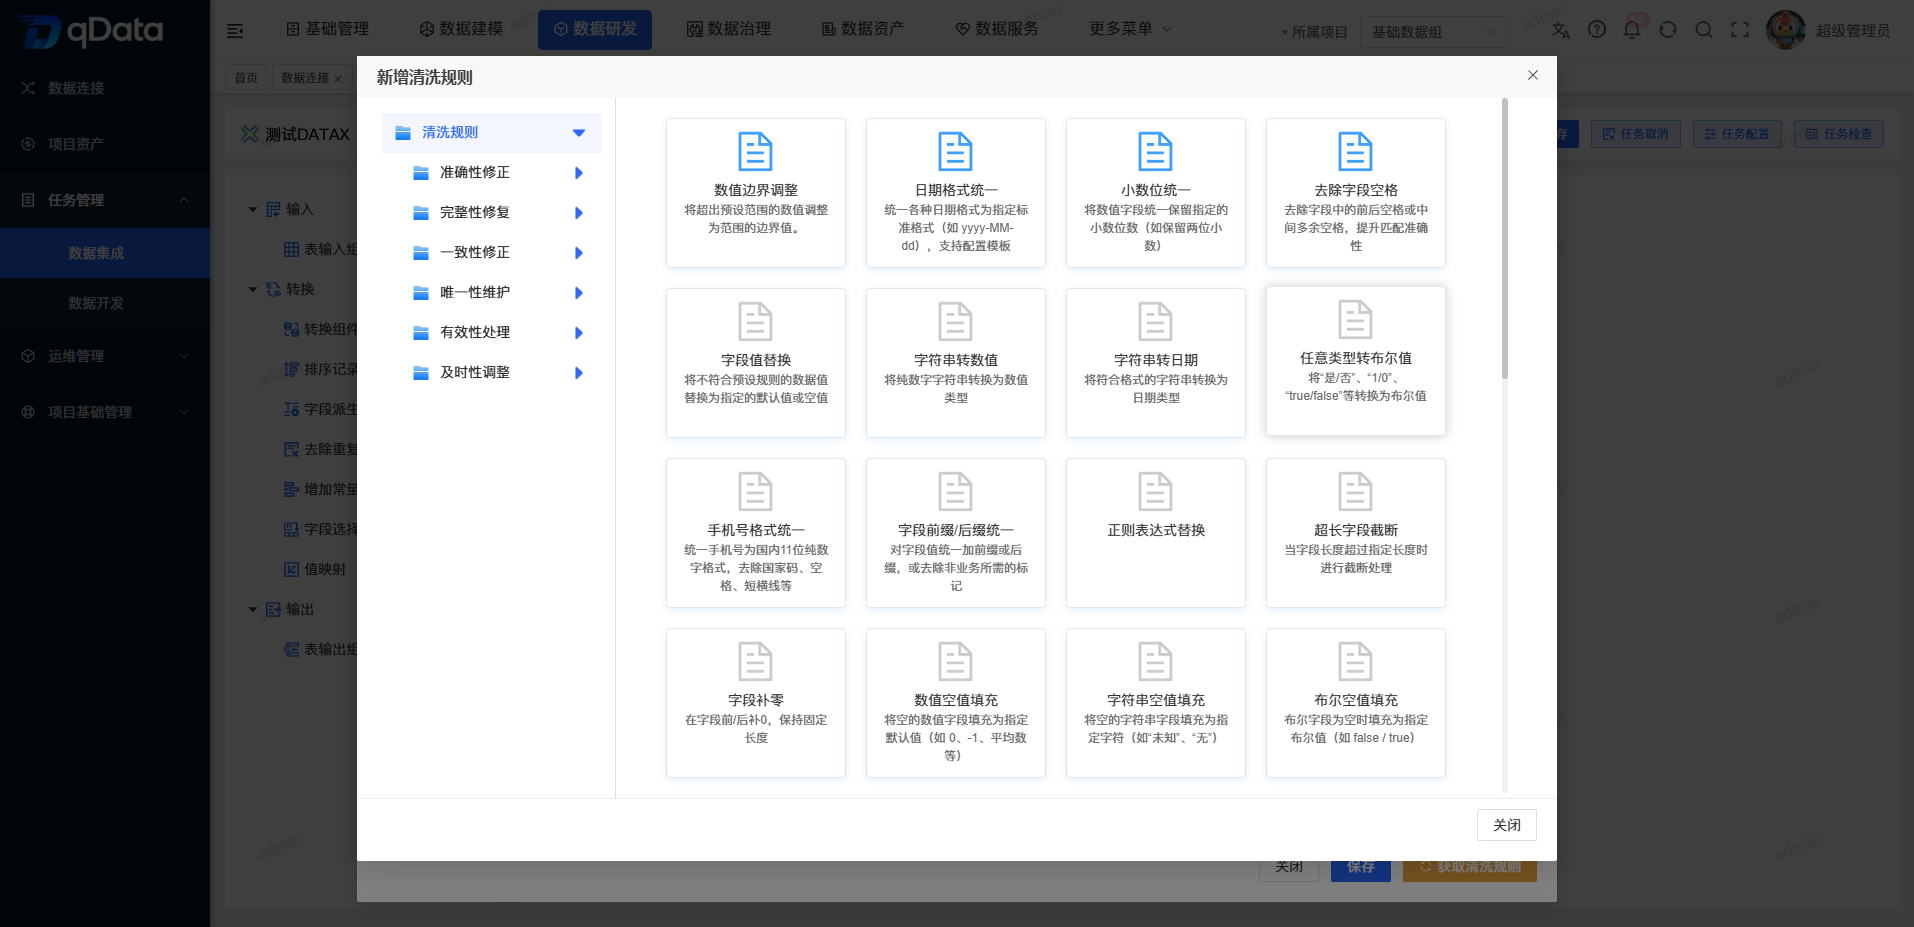
转换组件
转换组件用于对输入数据进行字段映射、字段处理、规则配置和数据清洗。配置转换规则后,可将处理结果传递给下游输出组件。
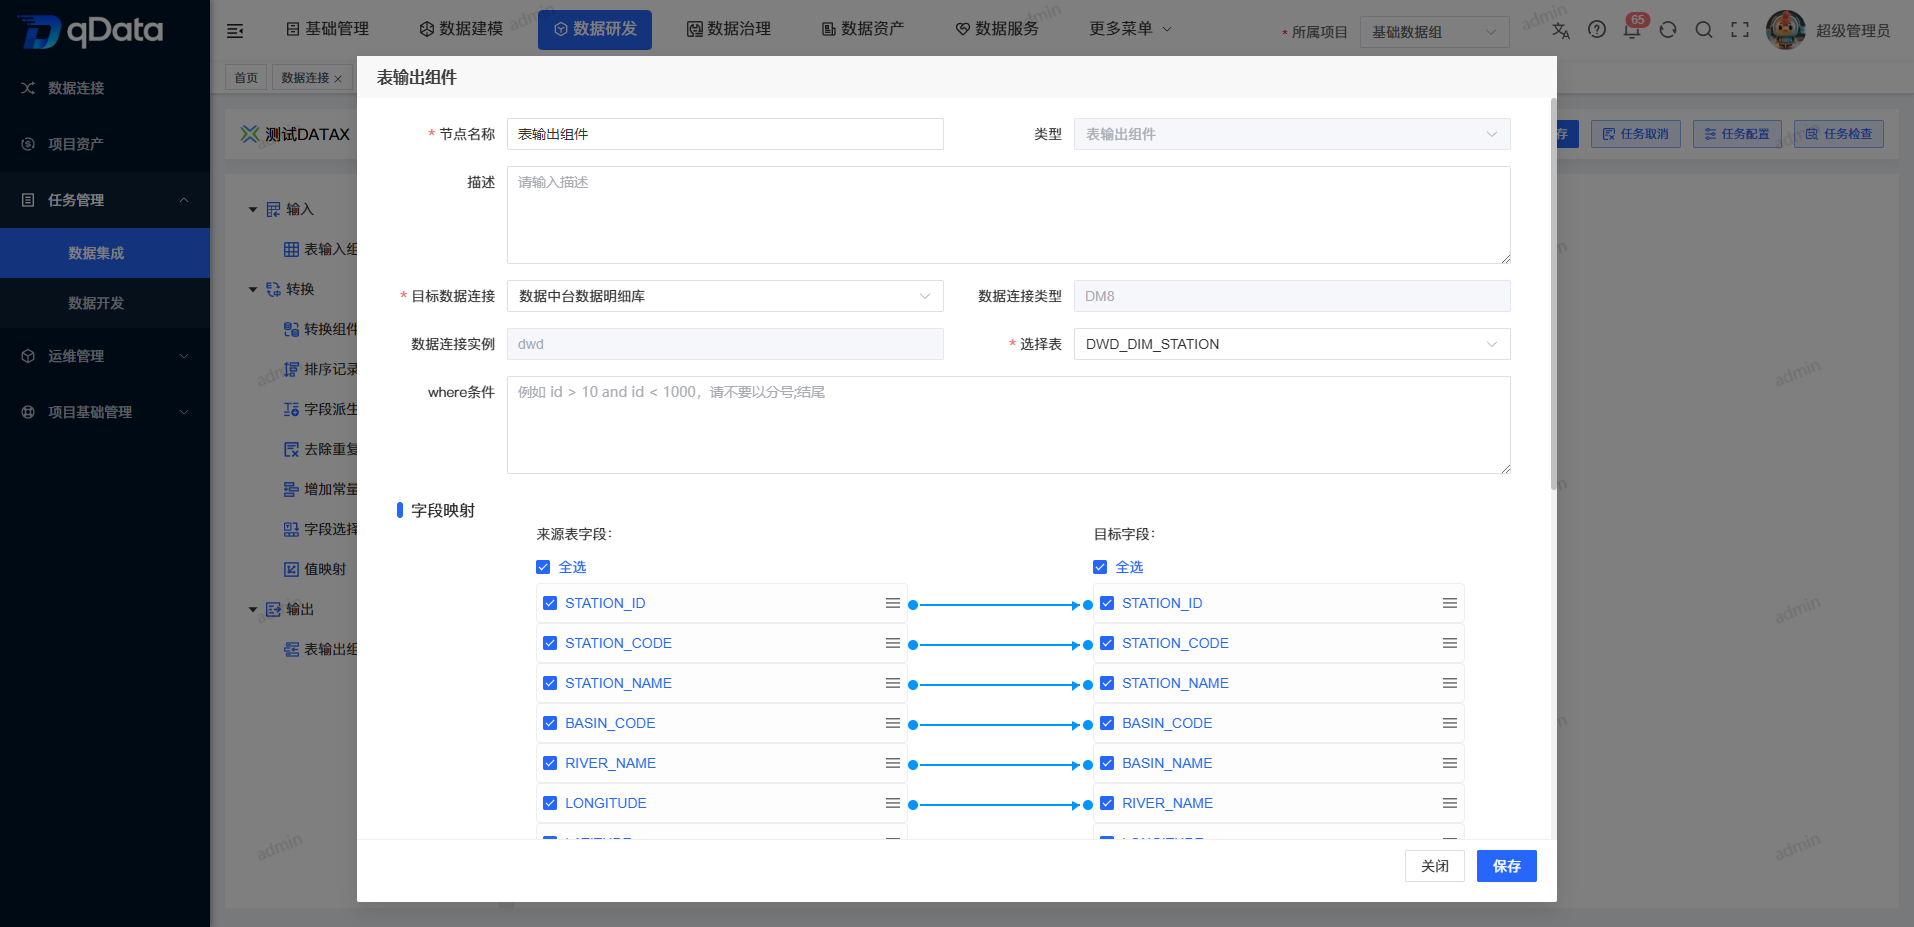
表输出组件
表输出组件用于配置目标端写入信息,通常需要选择目标数据连接、目标库表、字段映射、写入模式等参数。
配置规则
- 同一画布内的节点名称不建议重复。
- 输入组件通常作为流程起点,输出组件通常作为流程终点。
- 上游字段发生变化后,应重新核对下游字段映射。
- DataX 任务建议优先确认源表字段、目标表字段和写入模式,避免执行后出现字段不匹配。
修改任务
选择需要修改的数据集成任务,在操作列中点击【修改】按钮,调整任务基础信息、执行策略或资源参数。若任务已上线或调度已启用,请先关闭调度并将任务下线后再修改。
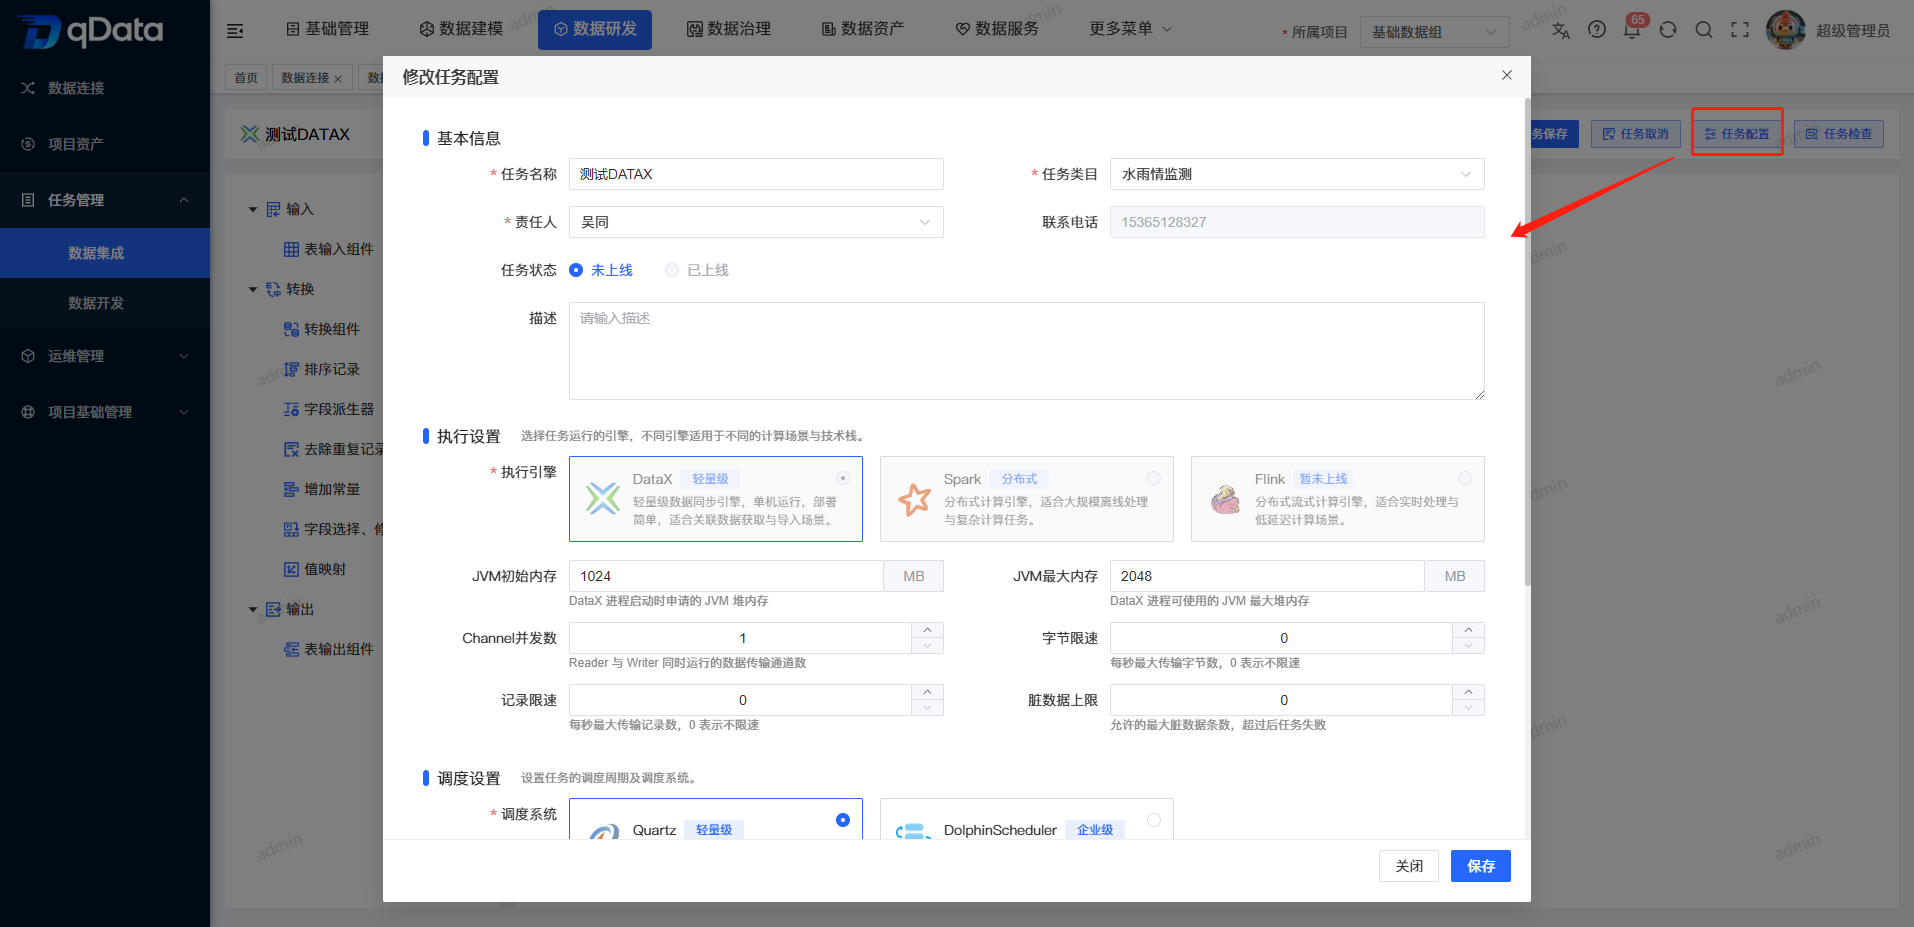
查看任务详情
选择需要查看的数据集成任务,点击操作列中的【详情】按钮,可查看任务基础信息、调度配置、执行配置、流程配置和运行相关信息。
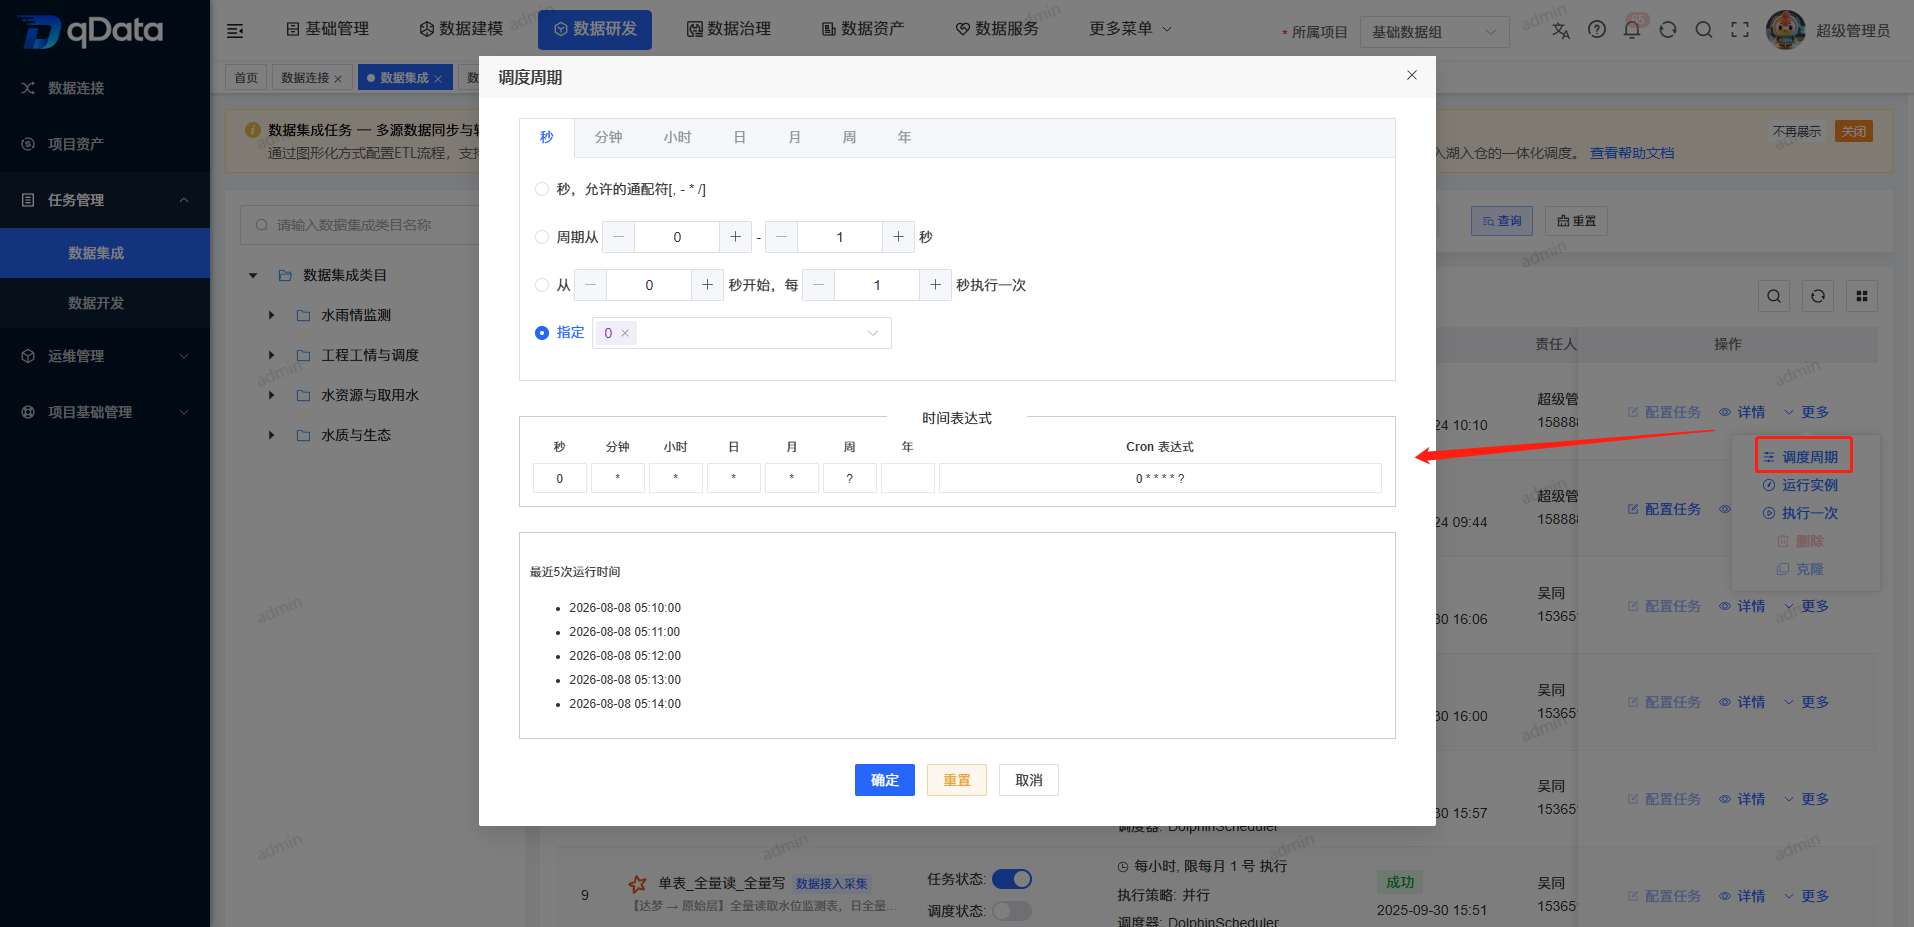
配置调度周期
选择需要调度执行的数据集成任务,点击操作列中的【更多】->【调度周期】按钮,在弹出框内填写或生成调度周期,并点击【确定】按钮保存。
根据当前场景选择一个入口:
新增任务时,点击调度周期右侧的【配置】。
维护已有任务时,在目标任务的【更多】菜单中点击【调度周期】。
在【秒】【分钟】【小时】【日】【月】【周】【年】页签中设置周期。
核对页面生成的 Cron 表达式。
核对页面展示的最近 5 次运行时间。
如需保存本次设置,点击【确定】。
核对任务表单或任务列表中已回显保存后的调度周期。
如不保存本次设置,点击【关闭】退出;关闭后原调度周期保持不变。
上线任务与启用调度
任务状态
选择需要上线或下线的数据集成任务,在任务状态列中点击【开关】按钮,即可完成上线或下线操作。
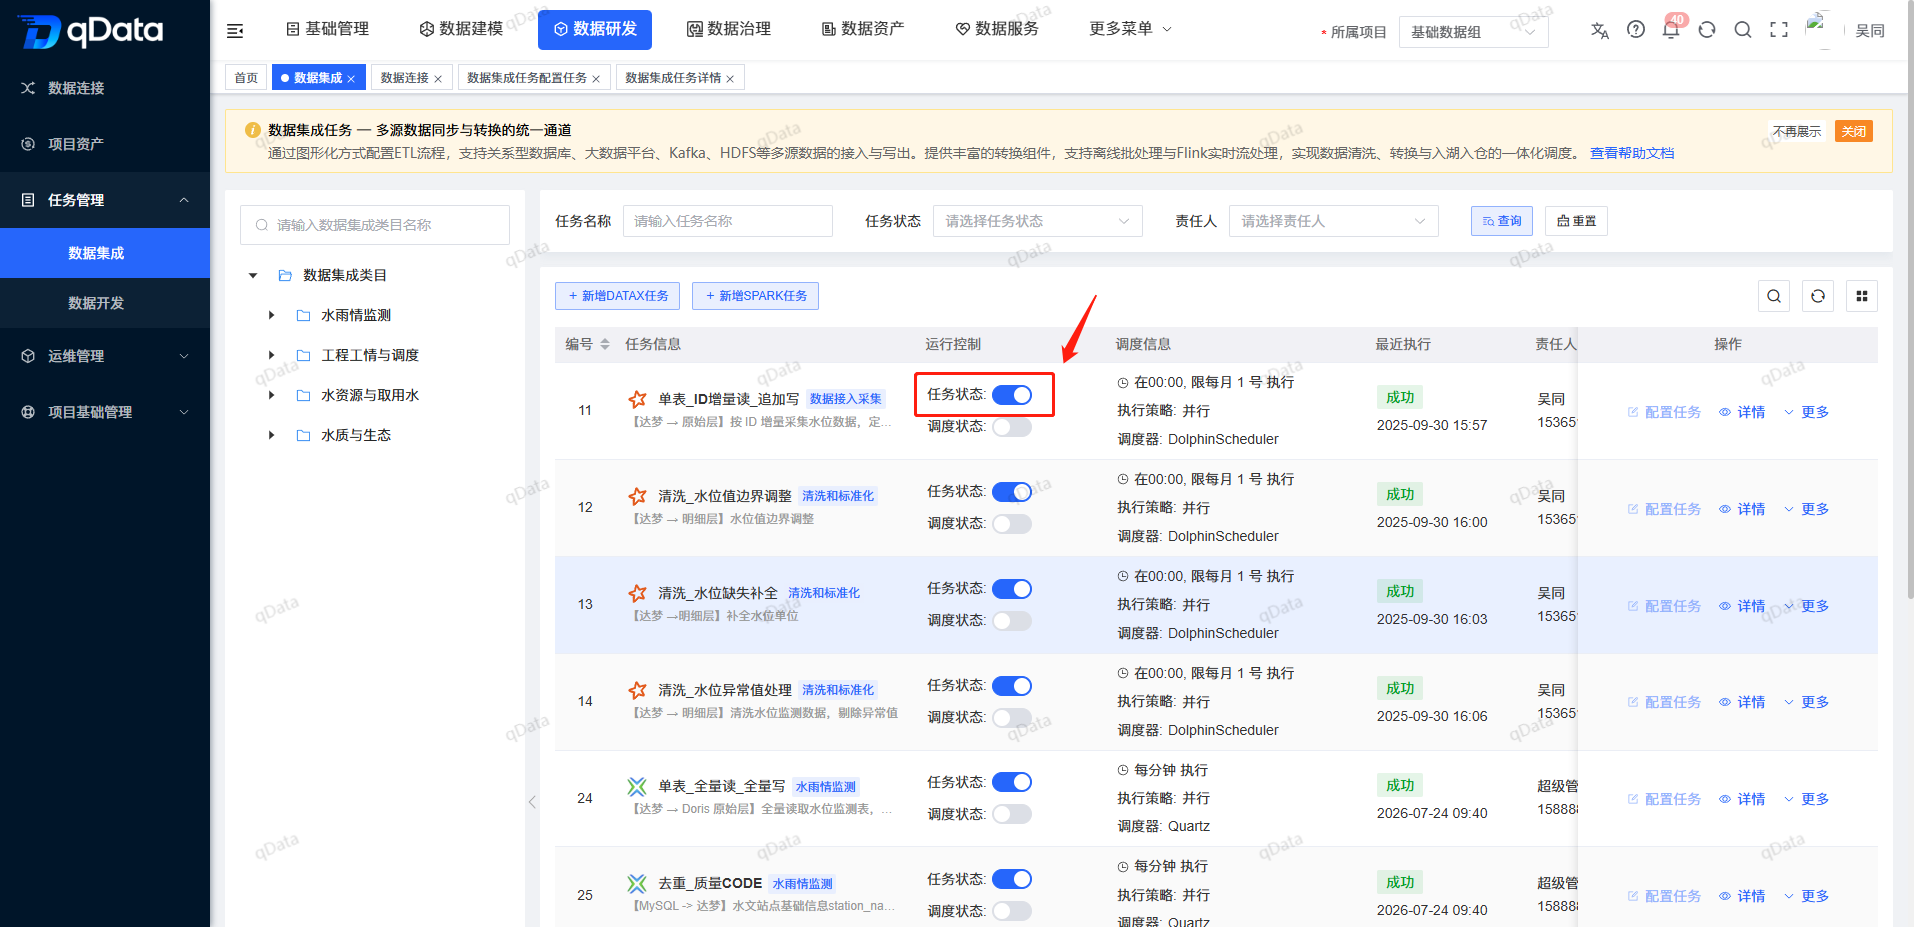
调度状态
任务上线后,可在调度状态列中点击【开关】按钮,完成调度启用或停用操作。
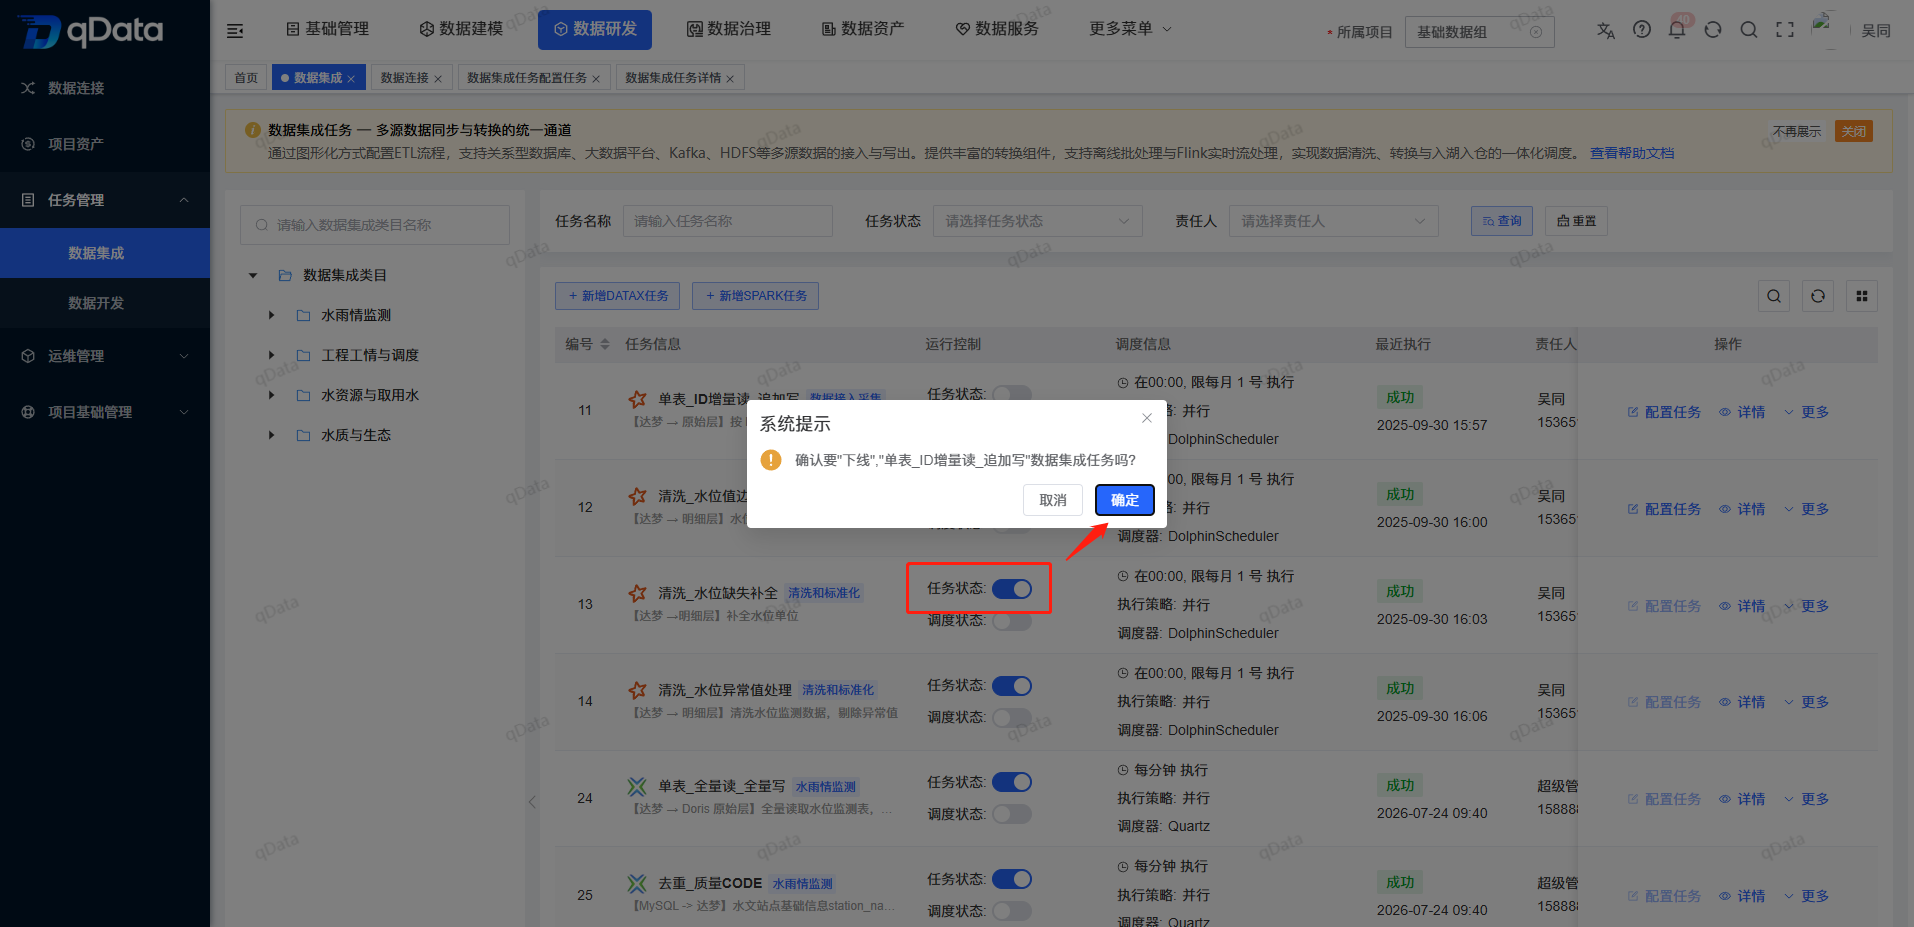
状态顺序
- 任务上线后才能启用调度或执行一次。
- 调度启用时不能修改周期,也不能将任务下线。
- 如需修改任务,请先关闭调度,再将任务下线。
运行实例
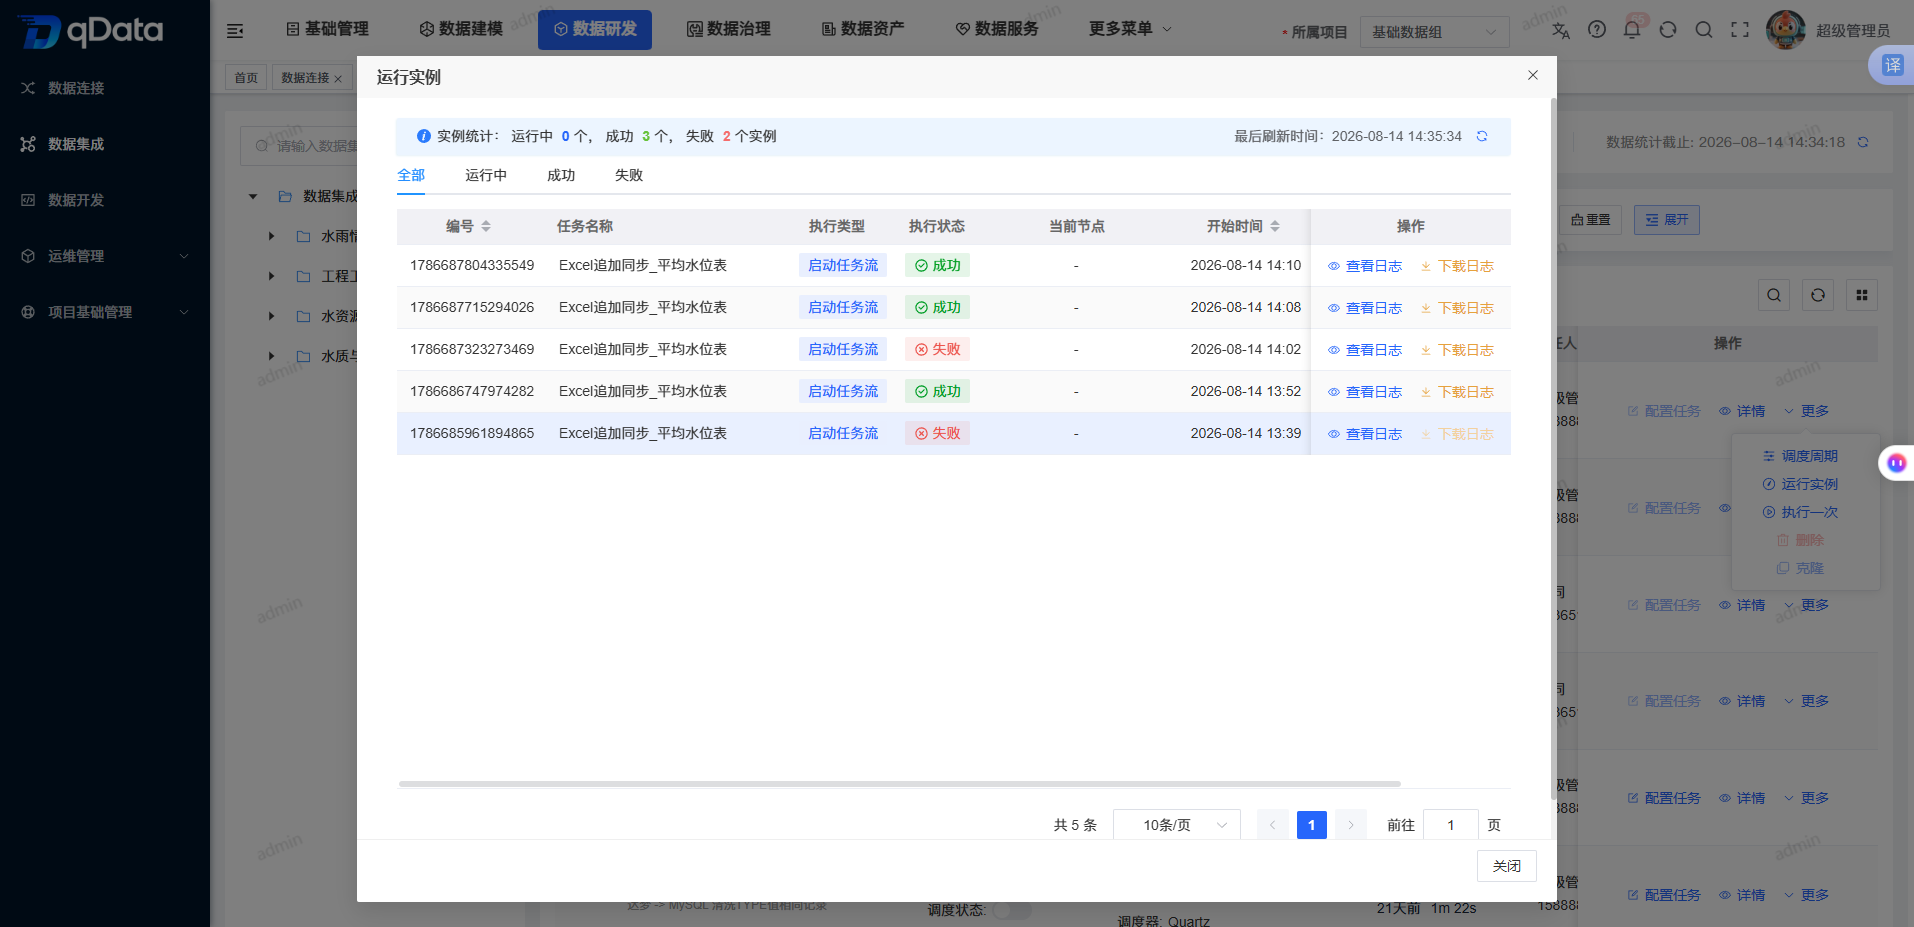
选择需要查看运行实例的数据集成任务,点击操作列中的【更多】->【运行实例】按钮,在弹出框内查看执行记录。运行实例可用于查看执行类型、执行状态、开始时间、结束时间、抽取量、写入量和责任人等信息。
执行一次
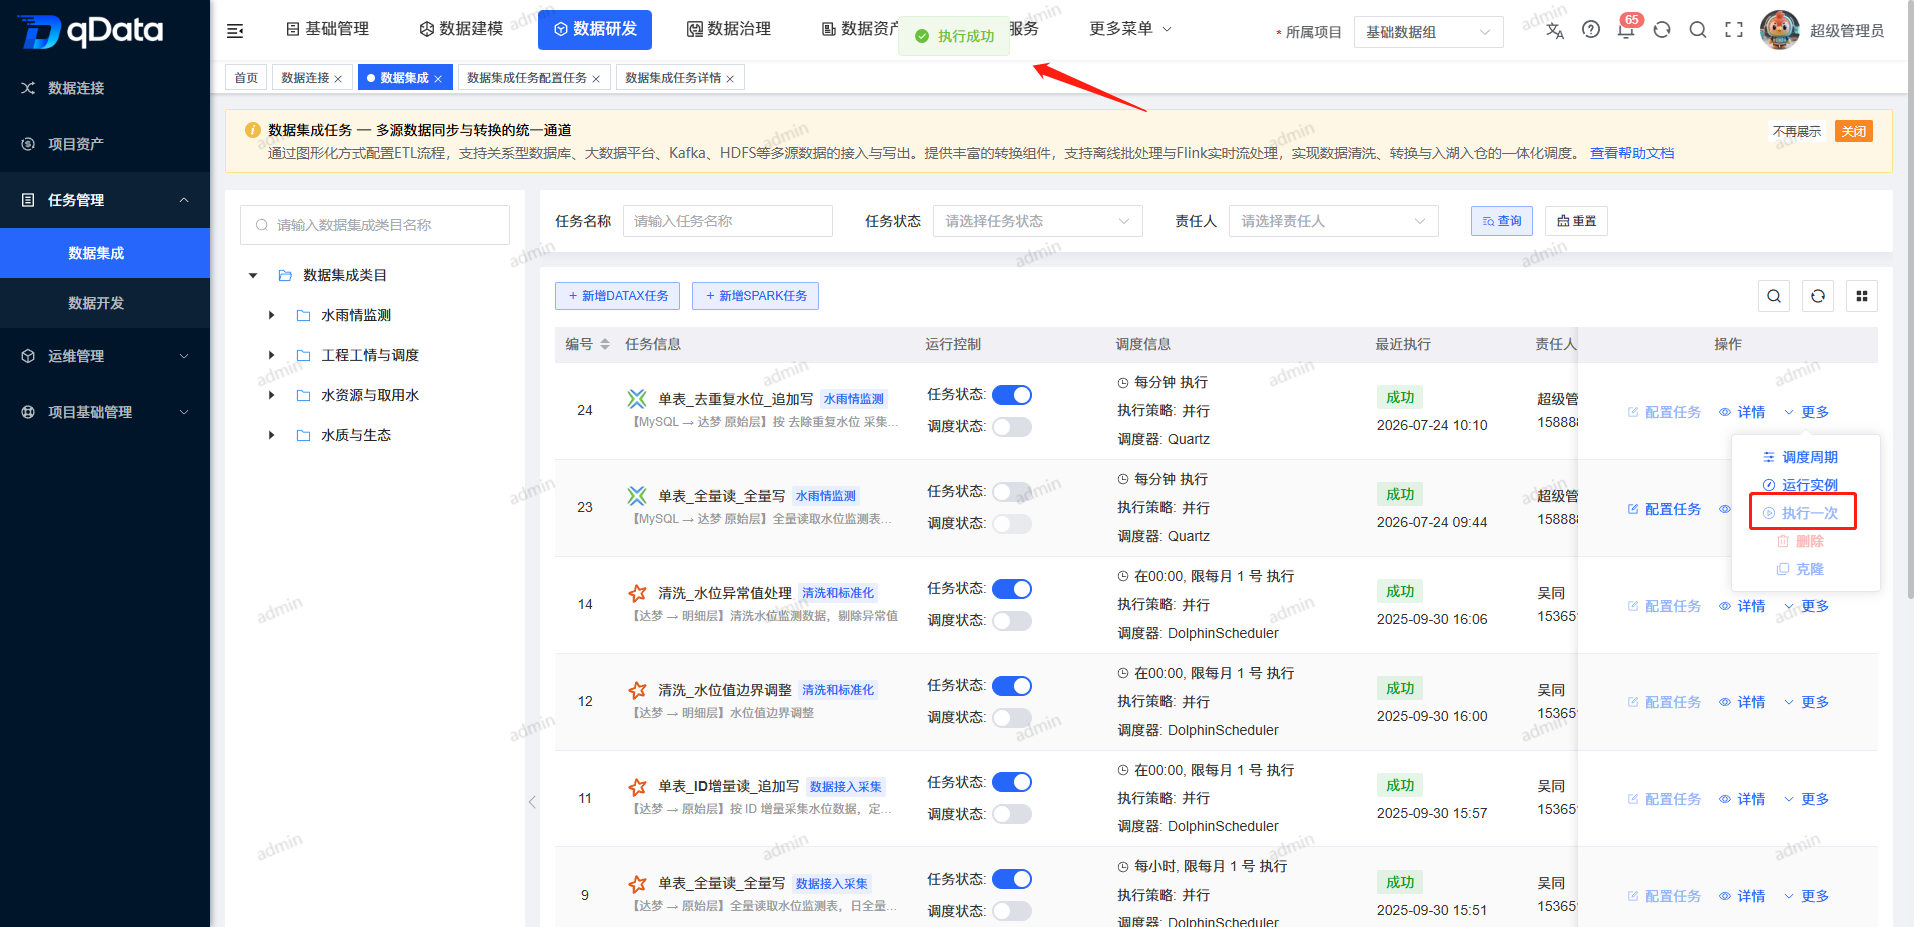
选择需要立即执行的数据集成任务,点击操作列中的【更多】->【执行一次】按钮,系统将立即发起一次任务执行,并提示相关信息。请求受理后,可通过【运行实例】查看执行结果。
克隆任务
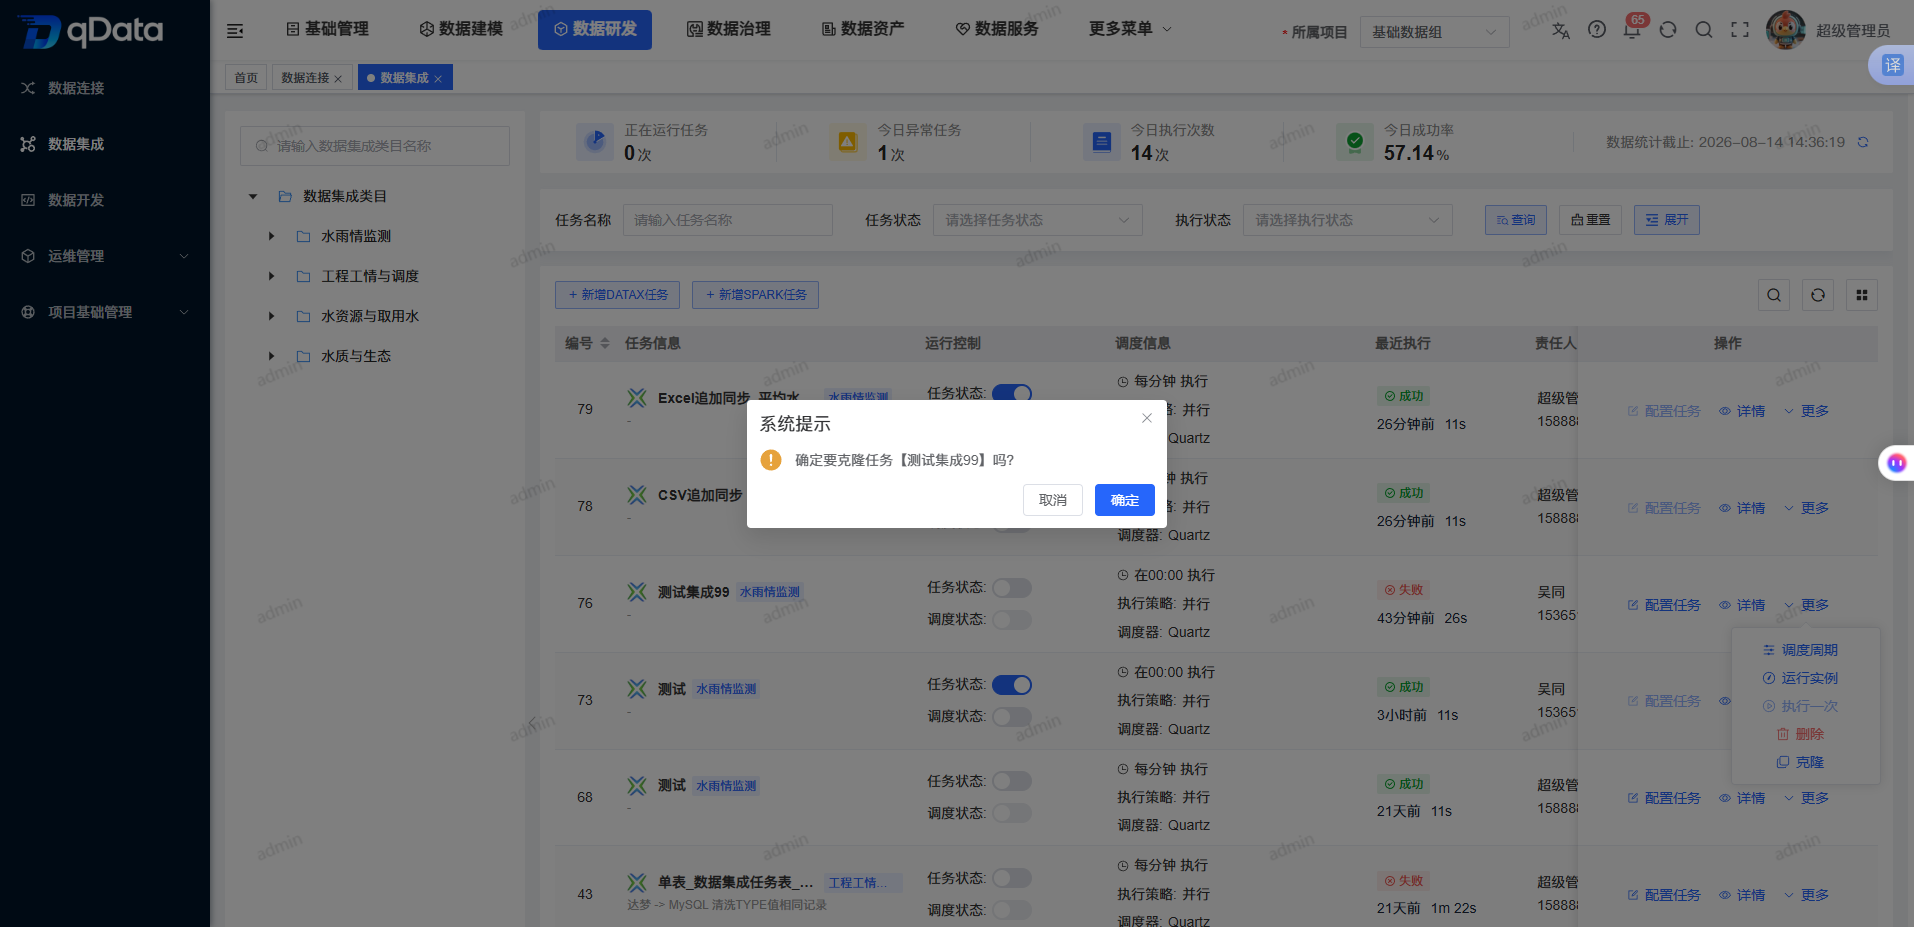
选择需要复制的数据集成任务,点击操作列中的【更多】->【克隆】按钮,系统将基于原任务生成副本。克隆任务可独立修改,不影响来源任务。
删除任务
选择需要删除的数据集成任务,点击操作列中的【更多】->【删除】按钮,并在确认提示中点击【确定】。系统将删除该数据集成任务。
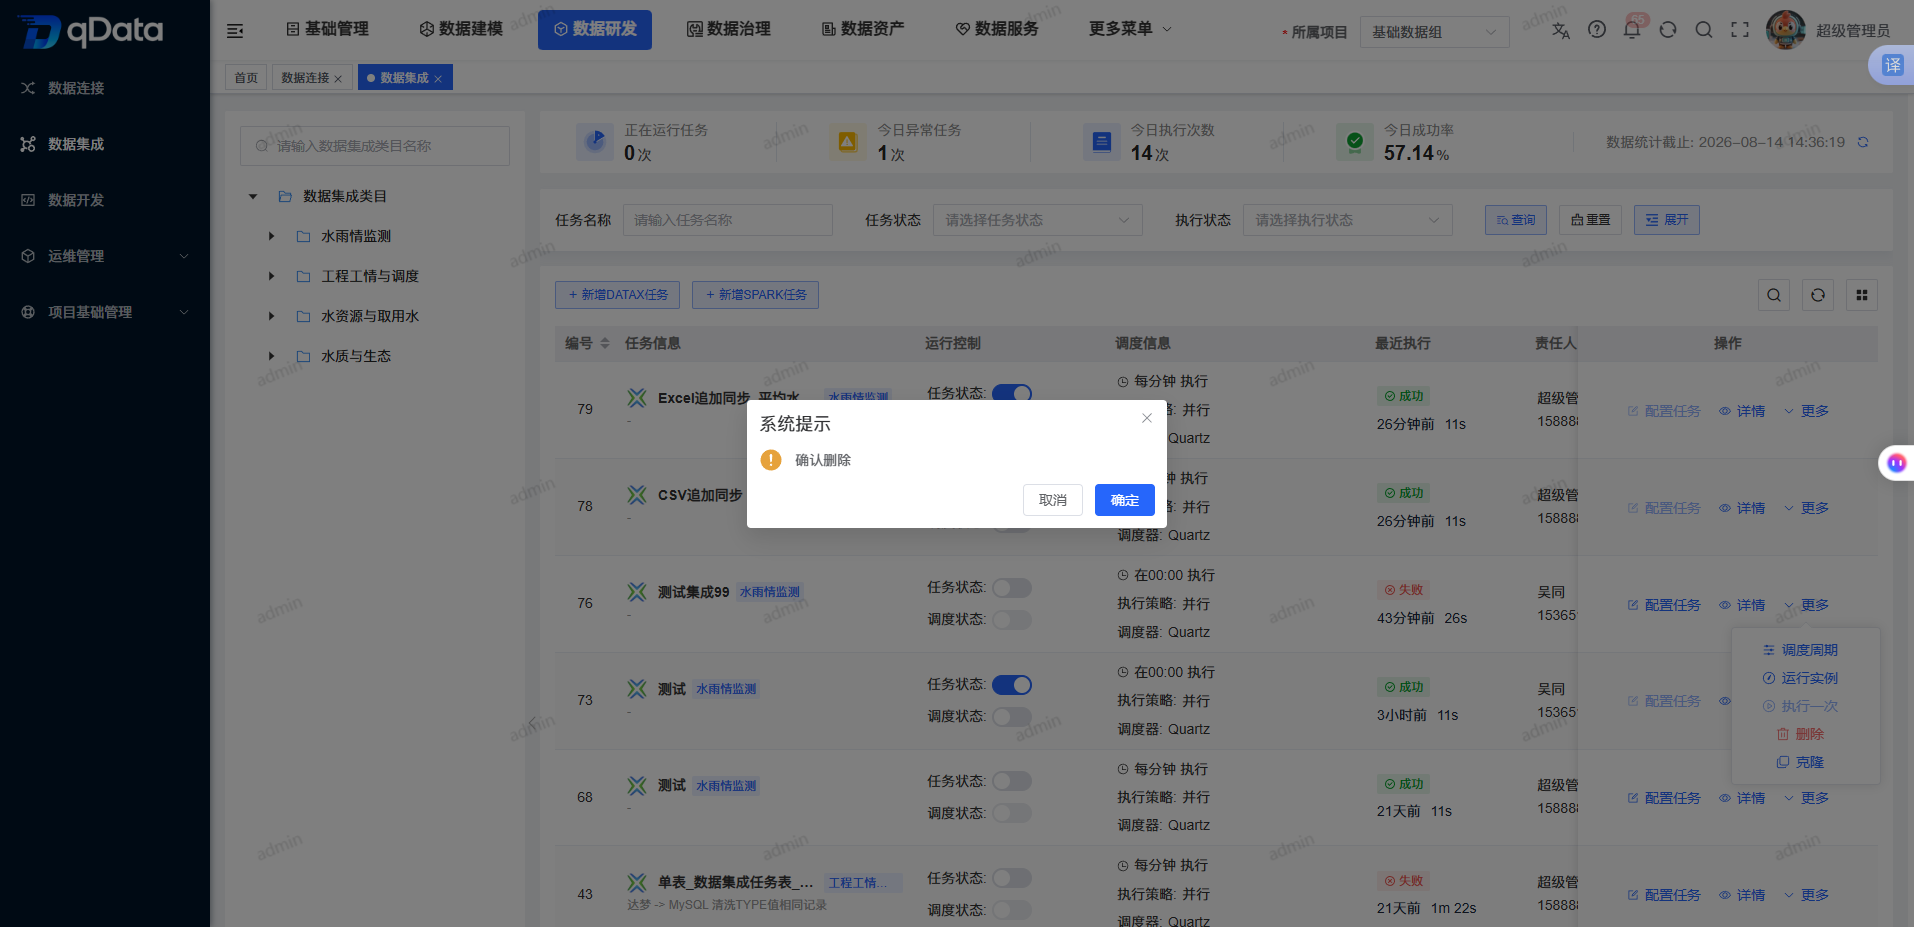
删除提示
上线任务不能删除;被作业引用的任务也不能删除。删除前请先将任务下线,并解除作业引用。
常见问题
为什么不能启用调度或执行一次?
任务必须先上线。未上线任务不能启用调度,也不能执行一次。为什么不能修改调度周期或将任务下线?
调度启用时不能修改周期,也不能将任务下线,请先关闭调度。DataX 和 Spark 应该如何选择?
中小表离线同步、轻量部署场景优先选择 DataX;大规模数据处理或需要分布式计算能力时选择 Spark。在哪里查看执行结果和日志?
从【更多】进入【运行实例】,定位目标记录后查看实例详情或日志。克隆后是否会影响来源任务?
不会。克隆产生独立副本,不影响来源任务。
总结
数据集成串联了任务创建、运行资源、可视化流程、校验保存、上线调度和实例日志。操作时请重点核对当前项目、任务状态、调度状态、DataX 执行配置和字段映射结果;需要修改任务时,先关闭调度并将任务下线。